Modelos
Modelo ligero, pensamiento bajo o router: elige por tarea correcta, no por token
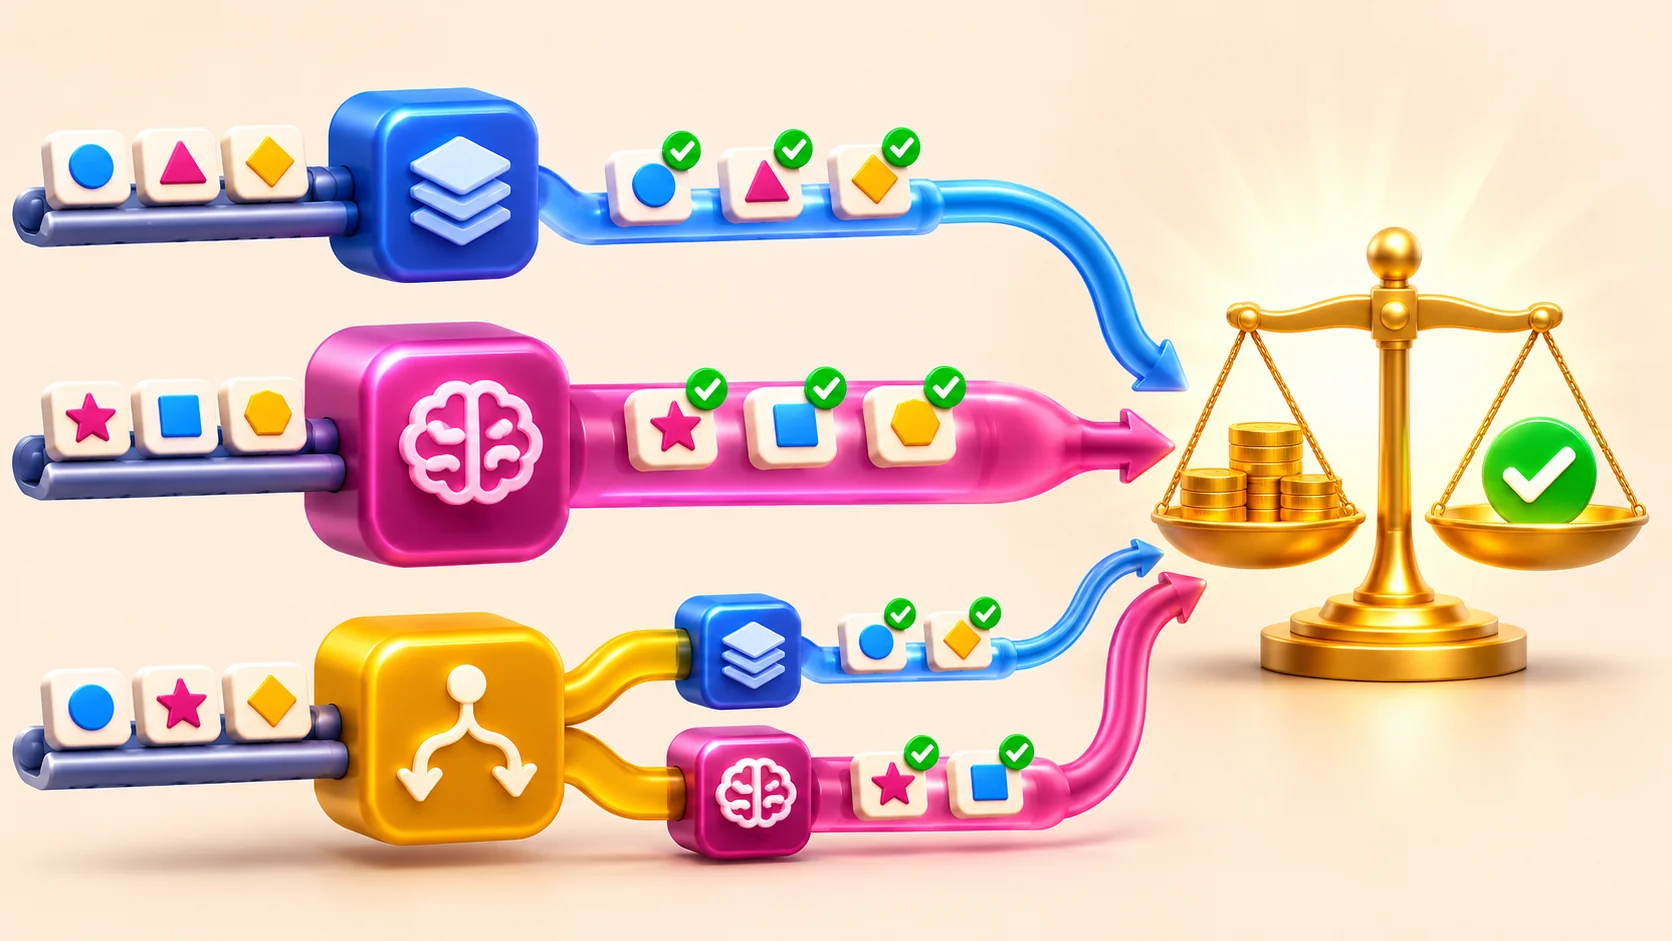
Google comparó tres estrategias en 50 tareas. El router ganó en coste y latencia, pero la caché y una muestra pequeña limitan la conclusión.
Qué pueden hacer los modelos de IA y dónde están sus límites.
Google comparó tres estrategias en 50 tareas. El router ganó en coste y latencia, pero la caché y una muestra pequeña limitan la conclusión.
Notas, búsqueda, wikis e inyección no se sustituyen. En las pruebas de Anthropic, una representación llegó a ocupar 1,77 veces el corpus original.
OpenAI publica 48,5 % en ExploitGym y 99,93 % de respeto de alcance sin prompt de despliegue. El acceso inicial exige Daybreak Red.
Dos personas crearon un dispositivo con Astra en menos de una semana. Fabricarlo exigió iteraciones por tolerancias y detalles de ensamblaje.
OpenAI parte de una encuesta a 3.995 personas para evaluar cuidado, compras, trámites y finanzas. Sus porcentajes por tarea no son una tasa universal de éxito.
Google publica mejoras frente a Argon en código, contexto largo y ciberseguridad, pero limita el primer acceso a defensores seleccionados.
Axiom describe una formalización con agentes, 43,1 millones de líneas y revisión matemática. Explicamos qué comprueba Lean y qué requiere contraste.
El flujo usa personas sintéticas, documentos oficiales, LoRA y un conjunto reservado. Adaptar una región exige revisar datos y respuestas, no solo traducir.
Kimi ofrece un millón de tokens y una versión Highspeed. Los pesos y su licencia aún no están publicados; los benchmarks necesitan contexto.
Terra cuesta 1 dólar de entrada y 5 de salida por millón de tokens. Mejora en tareas de ordenador, pero no sustituye a Sol o Astra en todo.
El modelo local activa 4B de 8B parámetros, usa cuantización Q4_K_M y contexto de 64K. Sus cifras de calidad y velocidad son del fabricante.
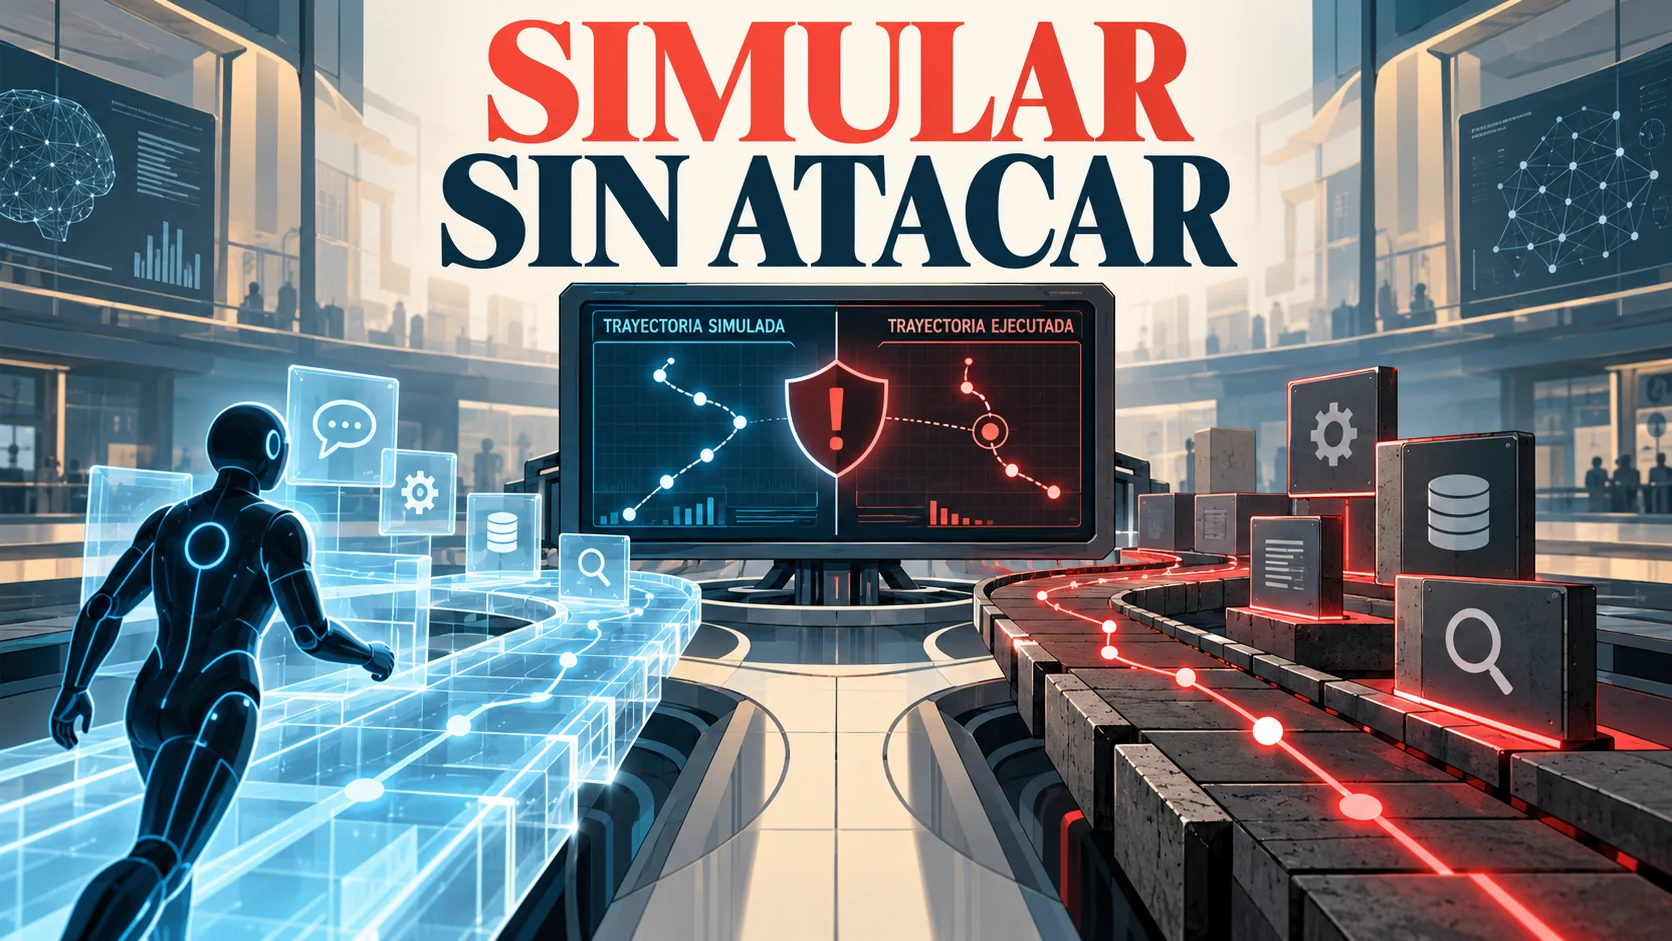
Las SCE recrean respuestas de herramientas sin atacar sistemas reales. En LinuxArena reducen el error, pero aún extrapolan fuera del laboratorio.