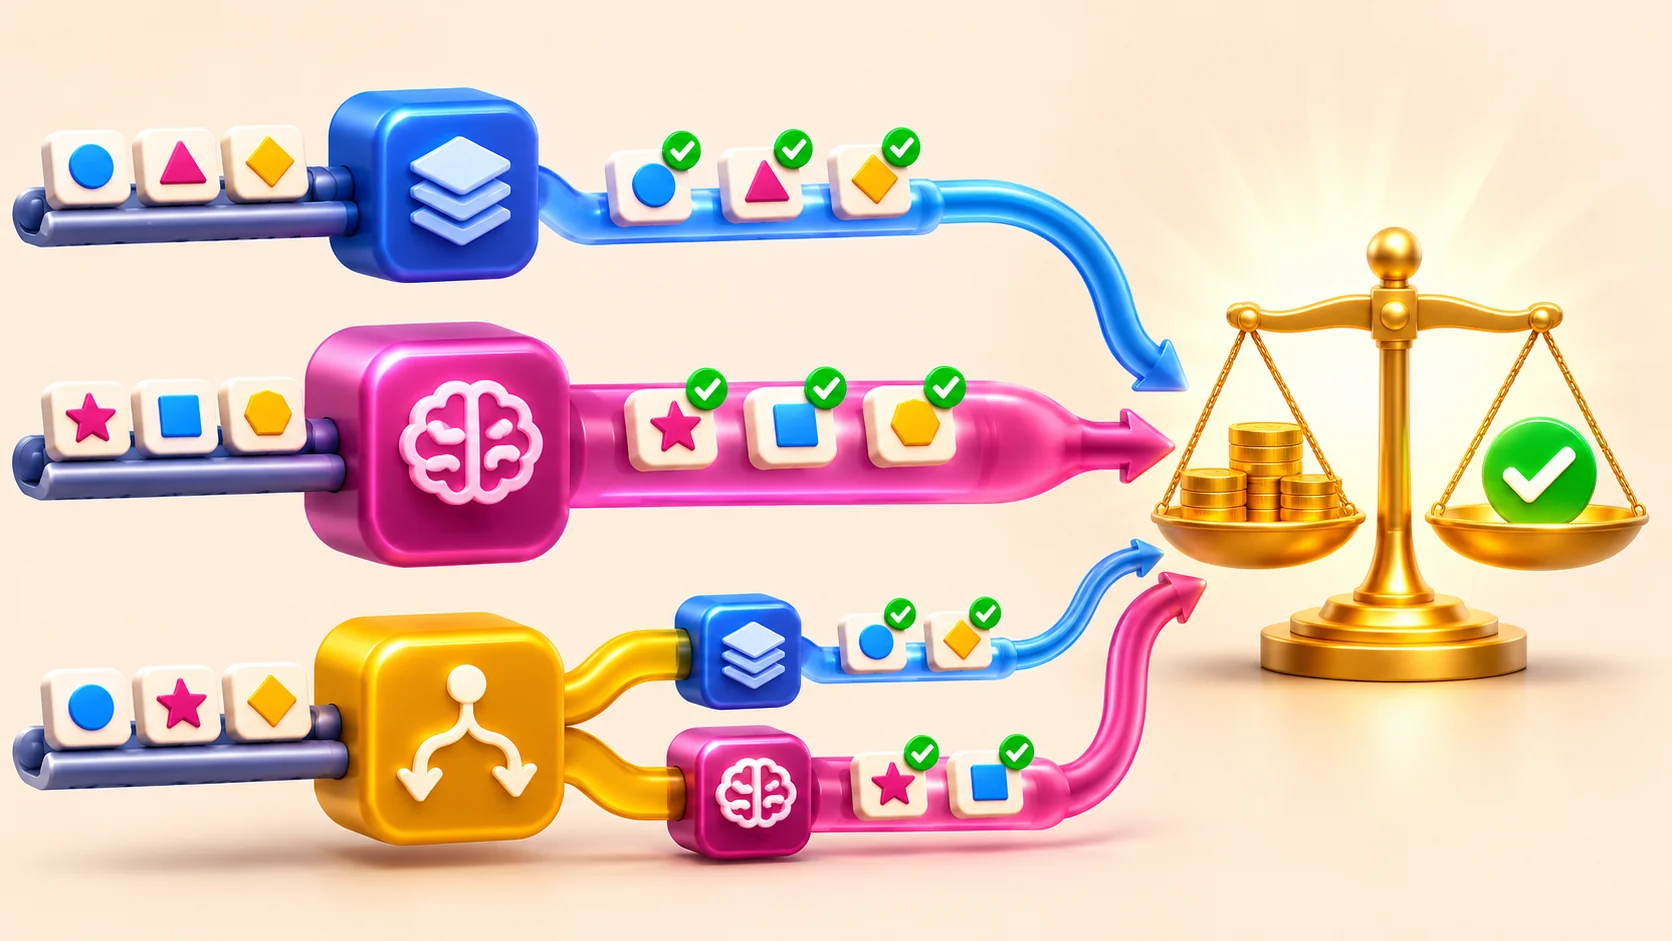
Empieza con un modelo rápido y pensamiento bajo; añade un clasificador solo si las tareas cortas y autónomas justifican otra llamada. Esa es la conclusión práctica de una prueba de Google con 50 preguntas de programación. El router acertó las 50 y redujo coste y espera frente a usar pensamiento bajo siempre, pero la muestra fue pequeña y se ejecutó una sola vez por configuración.
Qué conviene en cada caso
| Estrategia | Conviene cuando | Riesgo principal |
|---|---|---|
| Flash-Lite sin router | Extracciones, validaciones y clasificaciones simples toleran algunos fallos | Falló 6 de las 25 tareas difíciles de la muestra |
| Flash con pensamiento bajo | Quieres una línea base sencilla y el contexto se reutiliza en muchas llamadas | Pagas el mismo nivel en tareas triviales y complejas |
| Clasificador + Lite/Low | Hay muchas tareas cortas e independientes y puedes medir el acierto | Añade latencia, mantenimiento y otra posible clasificación errónea |
| Heurística por palabras o longitud | Solo como control barato en un dominio muy estable y probado | Cayó del 93,8 % en desarrollo al 70,6 % en 34 tareas nuevas |
En la prueba, Gemini 3.8 Flash con pensamiento bajo resolvió las 50 tareas. El router con Jev envió las simples a Flash-Lite y las complejas a Flash Low y también resolvió 50 de 50, con menor coste y tiempo en esa muestra. La heurística congelada terminó con 48 de 50.
Por qué limitar la salida no ahorró
Reducir maxOutputTokens de 4.096 a 300 no cambió el pensamiento consumido en las tareas fáciles. En cambio, rompió siete de las 25 difíciles: seis se quedaron sin espacio antes de responder y una terminó con una respuesta incorrecta. El límite es un techo de salida, no un control del nivel de razonamiento.
La caché cambia la decisión
Las tareas del estudio eran cortas e independientes. Un agente real puede reenviar un mapa del repositorio y definiciones de herramientas. La caché de contexto de Google descuenta entre el 75 % y el 90 % al reutilizar ese bloque, pero queda ligada a un modelo. Alternar modelos puede exigir dos cachés o perder el descuento. Para turnos largos y con contexto compartido, una configuración estable puede superar al router.
Cómo elegir sin extrapolar
- Mide coste por tarea verificada: incluye reintentos, herramientas, pensamiento y fallos.
- Ejecuta primero una línea base con el modelo ligero y pensamiento bajo.
- Separa tareas cortas de turnos con contexto grande y reutilizable.
- Construye un conjunto retenido que no se use para diseñar las reglas.
- Añade el router solo si mejora coste o latencia sin reducir la tasa de tareas correctas.
Jev es un ejemplo de TypeSafe; Google declara que no existe asociación ni respaldo comercial. También propone clasificadores alternativos, incluido DiffusionGemma autoalojado, cuyo coste se paga por hora de GPU y no por token. No consta que una opción gane en todos los entornos.
Transparencia: comparación elaborada con asistencia de IA a partir del experimento publicado por Google. Texploto no ejecutó las APIs ni reprodujo el benchmark; todas las cifras proceden del original y conservan sus límites.