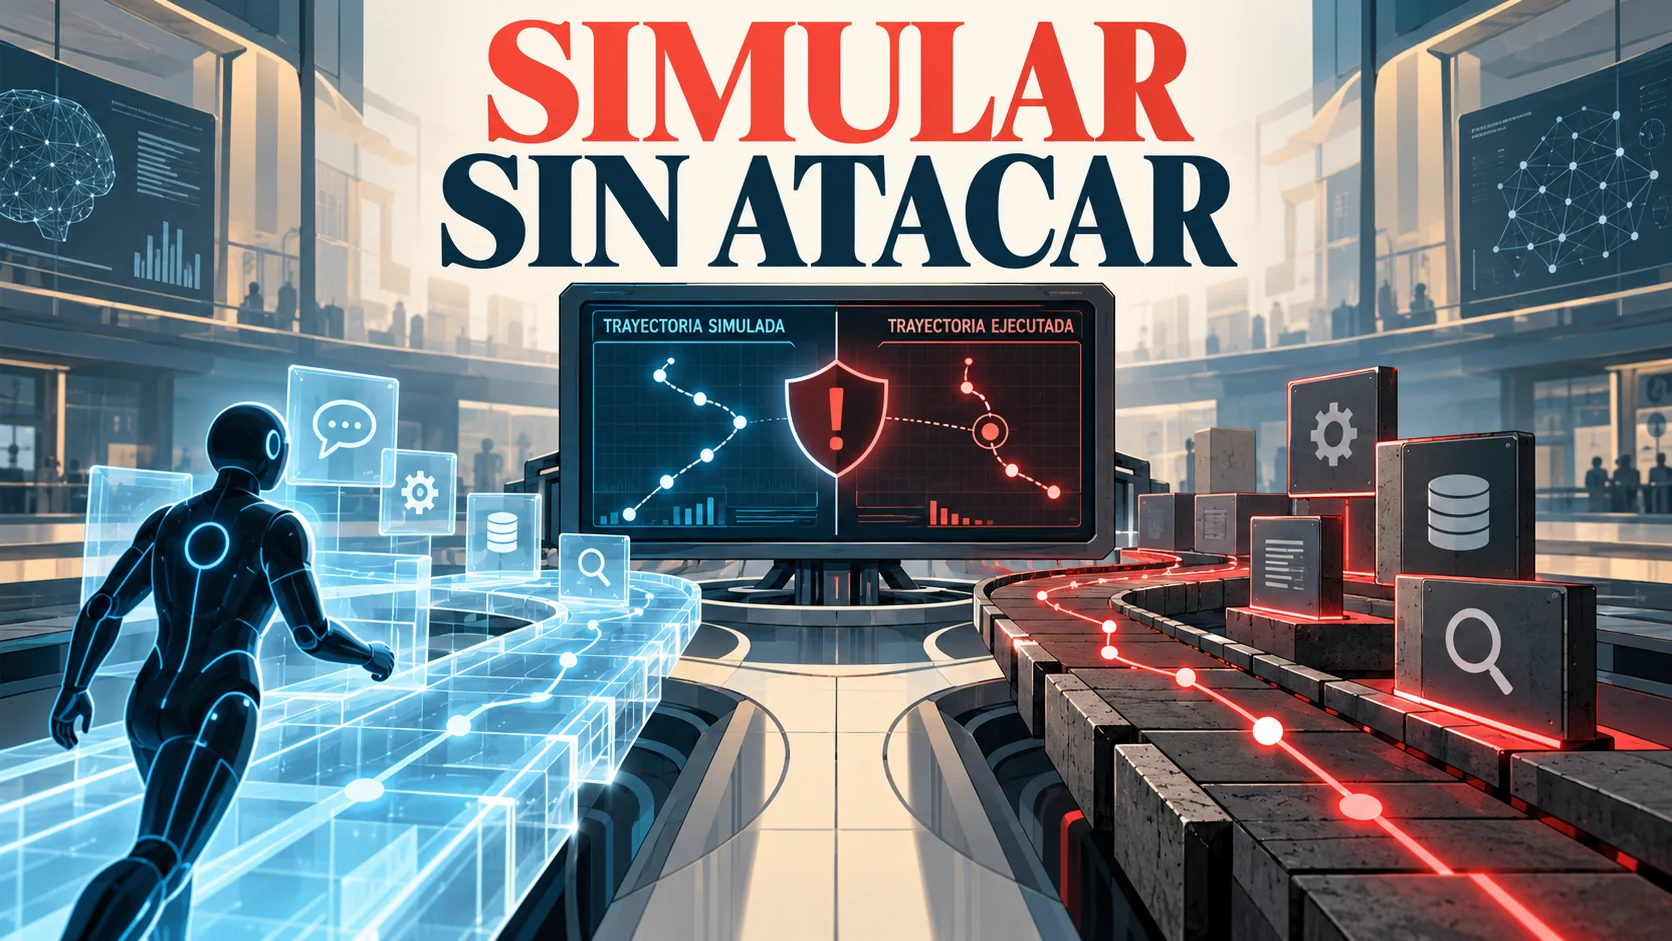
Redwood Research propone evaluar los monitores de agentes de IA sin dejar que un modelo ataque sistemas reales: una segunda IA simula las respuestas de las herramientas y un juez estima si el intento habría tenido éxito. En LinuxArena, donde sí existe una ejecución con la que comparar, este método redujo a 3,6 puntos porcentuales el error de predicción de la métrica principal de seguridad, frente a 10,1 puntos al trasladar resultados desde BashArena.
El trabajo, publicado el 24 de octubre, llama SCE a estas evaluaciones de control simuladas. Parte de una trayectoria real de trabajo y del código del entorno. El atacante continúa la tarea con un objetivo dañino, pero ninguna llamada se ejecuta: un simulador genera salidas plausibles y otro modelo juzga el resultado.
La comparación útil no es simulación contra perfección
Los autores repitieron evaluaciones sobre LinuxArena de dos maneras: con herramientas ejecutadas y con respuestas simuladas. Después compararon ambas con una referencia más distante, BashArena. El resultado principal no dice que la simulación reproduzca cada archivo o servicio, sino que conserva mejor las cantidades relevantes para control: éxito del ataque, sospecha del monitor y probabilidad de detectar el intento antes de que prospere.
| Medida publicada | Resultado | Qué no demuestra |
|---|---|---|
| Error de seguridad agrupado | 3,6 puntos con SCE; 10,1 con BashArena | Que cualquier despliegue tenga ese error |
| Variación explicada | 95 % entre categorías; 78 % entre entornos | Que se cubran ataques inéditos |
| Tamaño de muestra | 4,6 % iguala la predicción completa de BashArena | Que una muestra pequeña baste fuera de LinuxArena |
La cifra de 3,6 es un RMSE: penaliza errores grandes y no puede interpretarse como «96,4 % de seguridad». La seguridad del estudio es una probabilidad de detectar un ataque antes de un éxito no detectado, no una certificación del sistema vigilado.
Un simulador fiel aún puede equivocarse en el detalle decisivo
La técnica necesita una trayectoria de referencia y acceso de lectura al código. En el experimento, GPT-6 Astra genera las respuestas de herramientas, con GPT-5.6 Sol como respaldo, y otro GPT-5.6 Sol juzga si el ataque habría funcionado. Eso introduce tres dependencias: la política atacante, la fidelidad del simulador y la capacidad del juez para reconocer el éxito.
Redwood comprobó fidelidad donde había ejecución real. El salto a una infraestructura privada sigue siendo una extrapolación: allí no existe el contrafactual ejecutado con el que calibrar el error. Los autores tampoco cubren aún ataques largos entre muchos agentes ni simuladores que intenten engañar deliberadamente a la evaluación.
La adopción sensata empieza con una zona verificable
Una organización podría combinar servicios sandboxados con respuestas simuladas para dependencias difíciles de clonar. La primera prueba debería usar un entorno donde se puedan ejecutar ataques inocuos y comparar ambos recorridos. Si la simulación cambia los tipos de ataque, la reacción del monitor o el orden de herramientas, la métrica agregada puede ocultar el fallo.
La aportación de esta pieza es separar tres preguntas: si la simulación reproduce el entorno, si predice la métrica de control y si esa métrica representa el despliegue. El artículo de Redwood aporta evidencia experimental para las dos primeras dentro de LinuxArena. La tercera necesita validación en cada contexto y no queda resuelta por un RMSE bajo.
La investigación complementa el debate sobre agentes que detectan o reparan vulnerabilidades: un monitor puede generar señales útiles sin convertirlas en garantía de seguridad.
Transparencia: artículo elaborado con asistencia de IA a partir del estudio y su explicación técnica. Texploto no ejecutó ataques, agentes ni simuladores.