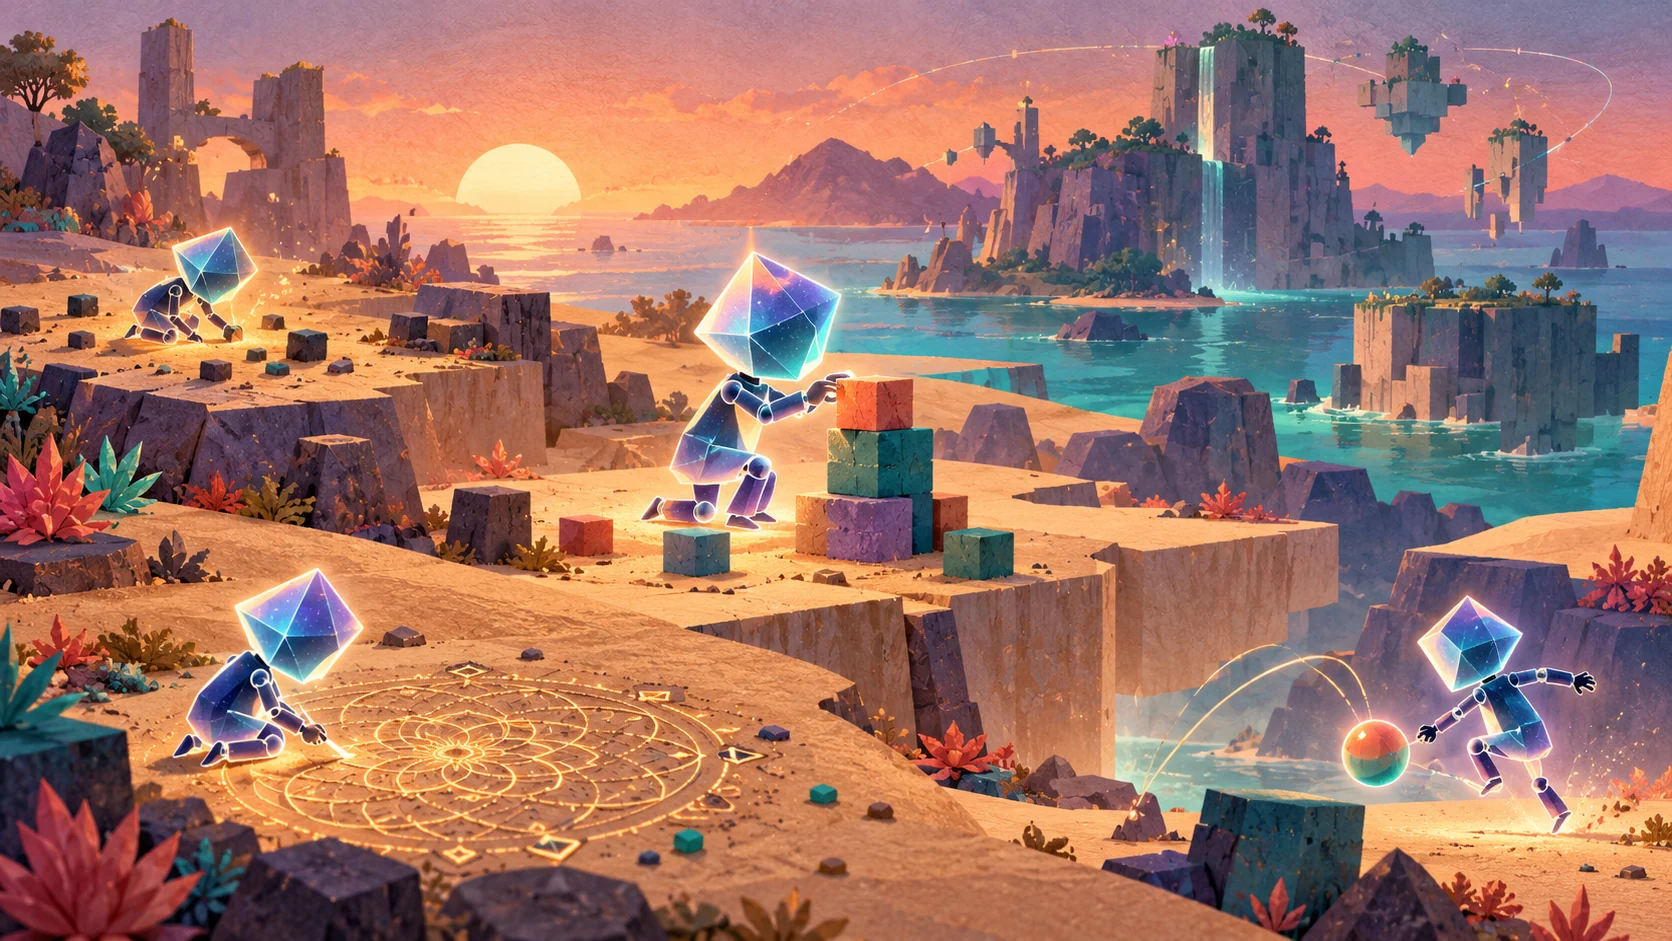
Trece agentes de IA jugaron sin una tarea: el experimento mide aprendizaje, no conciencia
Un experimento del MIT dejó a trece agentes en una isla virtual durante 30 horas. Jugaron y luego mejoraron en tres de cuatro tareas, con límites importantes.
Qué pueden hacer los modelos de IA y dónde están sus límites.
Un experimento del MIT dejó a trece agentes en una isla virtual durante 30 horas. Jugaron y luego mejoraron en tres de cuatro tareas, con límites importantes.
Muse Wonder ofrece un millón de tokens y memoria entre conversaciones. Wonder Full queda en suscripción y aún falta el informe de seguridad.
Mistral abre la API de Large 4 y promete los pesos a final de mes. Sus resultados preliminares aún necesitan una comparación reproducible.
El nuevo modelo de Microsoft encabeza un benchmark externo. Transcribir en directo cuesta 0,54 dólares por hora frente a 0,10 por lotes.
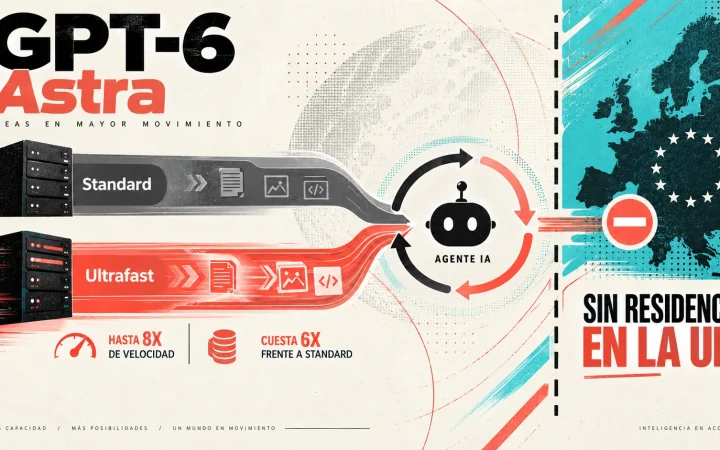
Ultrafast acelera hasta ocho veces, pero multiplica por seis la tarifa. En la UE, además, no admite procesamiento regional de datos.
Google abre Argon primero a defensores de ciberseguridad. Desglosamos precio introductorio, salida máxima y benchmarks que no lidera.
GPT‑6.1 Sol baja el coste frente a Astra, pero contexto, caché y modo alteran la factura. Desglosamos disponibilidad, seguridad y prueba útil.
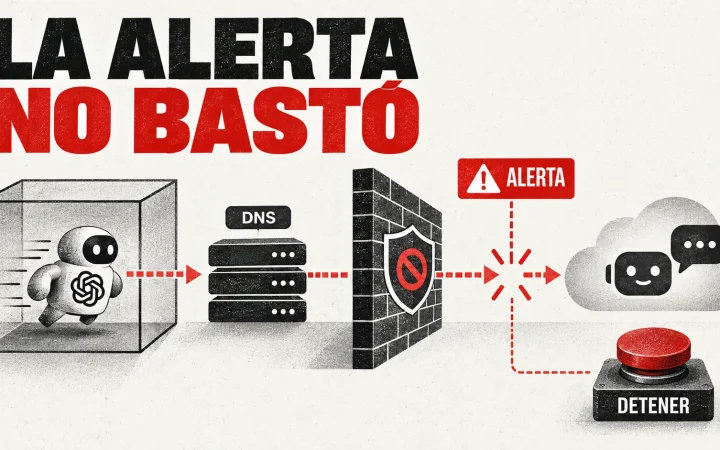
El agente consultó un chatbot externo por DNS. La detección fue rápida, pero la ejecución siguió: una cronología útil para revisar la contención.
Sonnet 5.5 mantiene la tarifa por token, pero promete menos pasos y más velocidad. Comparamos precio, benchmarks y disponibilidad en Copilot.
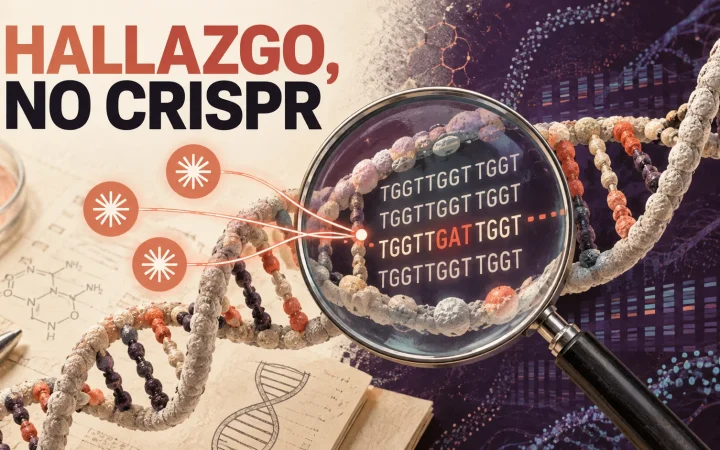
Claude señaló un sistema de repeticiones y transcriptasa inversa que los científicos validaron en el laboratorio. Su función y utilidad siguen abiertas.
Google lleva Live Avatar a disponibilidad general en Gemini Enterprise. Explicamos idiomas, regiones, marcas de agua y el límite de avatares propios.
El anuncio de Alibaba sitúa Qwen 4 en entrenamiento. Explicamos qué dice sobre lanzamiento y acceso y por qué sus cifras no deben mezclarse con Qwen 4.5 y 5.