Microsoft ha lanzado MAI-Transcribe-2-Streaming para convertir voz en texto mientras la persona todavía habla. Está en vista previa pública, admite 60 idiomas y puede usarse mediante una API Realtime compatible con WebSocket o el SDK de Azure Speech. La comparación interesante no es solo si comete pocos errores, sino cuánto cuesta mantener esa inmediatez.
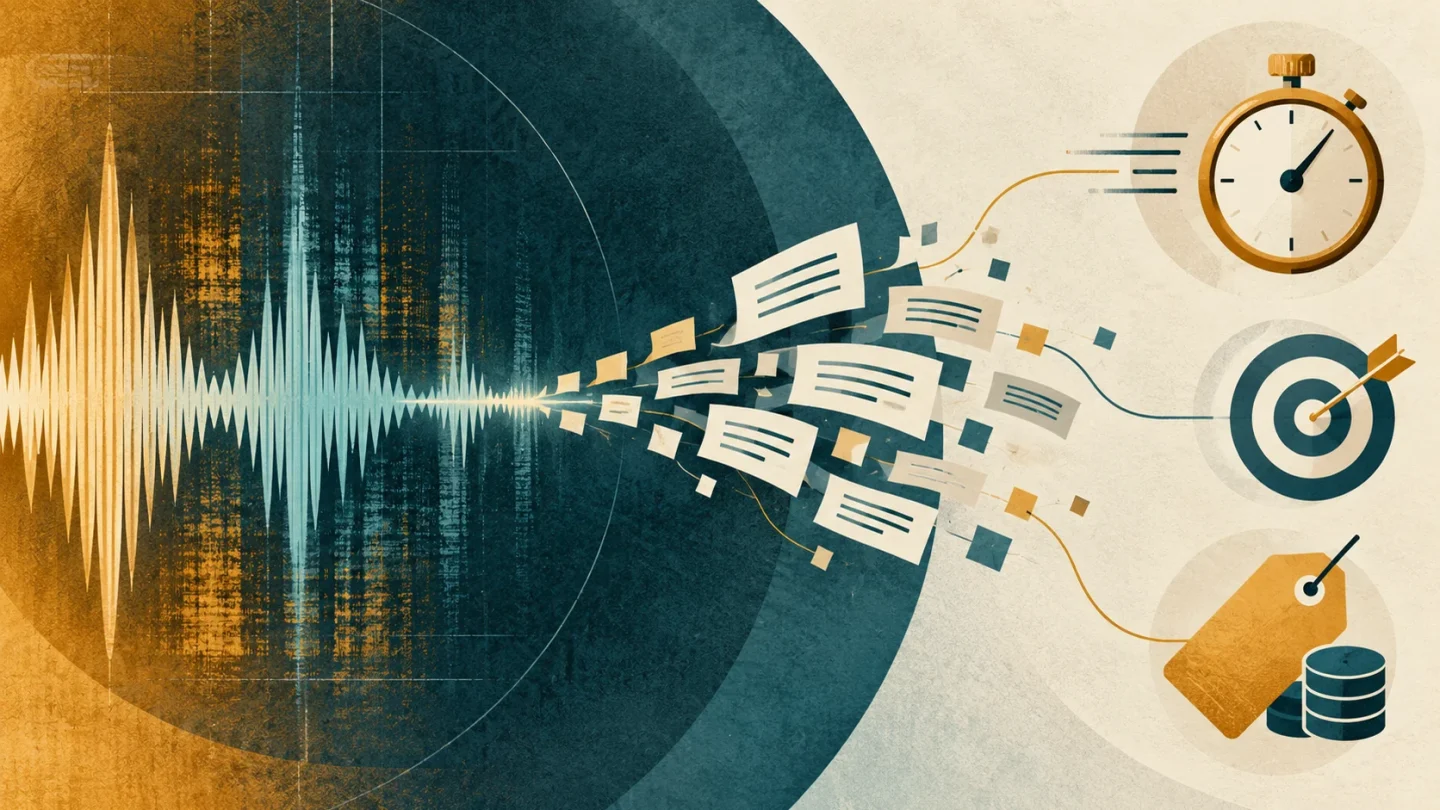
Microsoft afirma que el modelo alcanza un 2,5 % de tasa de error de palabras y entrega el texto final 0,13 segundos después de detectar el final del habla. Artificial Analysis lo situó primero en su evaluación de transcripción en streaming, por delante de Grok Voice Transcribe 2.0, que rondaba el 2,7 % y 0,49 segundos. La metodología combina unas ocho horas de audio y pondera AgentTalk, VoxPopuli y Earnings22; no representa todos los acentos, ruidos ni dominios.
El precio de tiempo real frente al trabajo por lotes
La tarifa introductoria publicada es de 0,54 dólares por hora de audio hasta final de 2026, equivalente a 9 dólares por 1.000 minutos. La variante MAI-Transcribe-2 para archivos cuesta 0,10 dólares por hora. Por tanto, procesar en directo resulta 5,4 veces más caro que transcribir después con el modelo de la misma familia.
Ese multiplicador ayuda a elegir arquitectura. Los subtítulos en directo, un agente telefónico o una alerta durante una llamada sí necesitan parciales rápidos. Un archivo de una reunión que nadie leerá hasta mañana puede enviarse al flujo por lotes. Otra opción es usar streaming para la interacción y reprocesar la grabación después cuando se necesite una versión estable con otras funciones.
Qué demuestra el benchmark y qué deja fuera
WER cuenta sustituciones, omisiones e inserciones; cuanto más bajo, mejor. La latencia de 0,13 segundos comienza tras la detección del final de habla, no cuando la persona empieza a pronunciar una frase. Tampoco incluye necesariamente toda la demora que verá un usuario entre micrófono, red, interfaz y síntesis de voz.
La documentación de Microsoft advierte además que la vista previa carece de acuerdo de nivel de servicio y no se recomienda todavía para cargas de producción. Una primera evaluación razonable debería conservar audios de referencia propios, incluir nombres y números difíciles, medir cuánto cambian los textos parciales y contar errores por idioma y entorno acústico.
Una regla sencilla para decidir
Si una persona debe actuar antes de que termine la conversación, paga por streaming y mide la estabilidad de los parciales. Si el resultado puede esperar, empieza por lotes y compara la factura. El primer puesto en un benchmark respalda una ventaja en esa muestra; no demuestra por sí solo que sea el mejor modelo para una llamada española con ruido, vocabulario jurídico o varios interlocutores.
Nivel de evidencia: prueba independiente publicada por Artificial Analysis, documentación primaria y anuncio del fabricante. Texploto no ha enviado audio al servicio.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. No se han ejecutado los productos o sistemas descritos.