La idea clave
Jev está diseñado para entregar valores que una aplicación puede utilizar directamente. Acertar con el formato y acertar con la decisión son comprobaciones distintas.
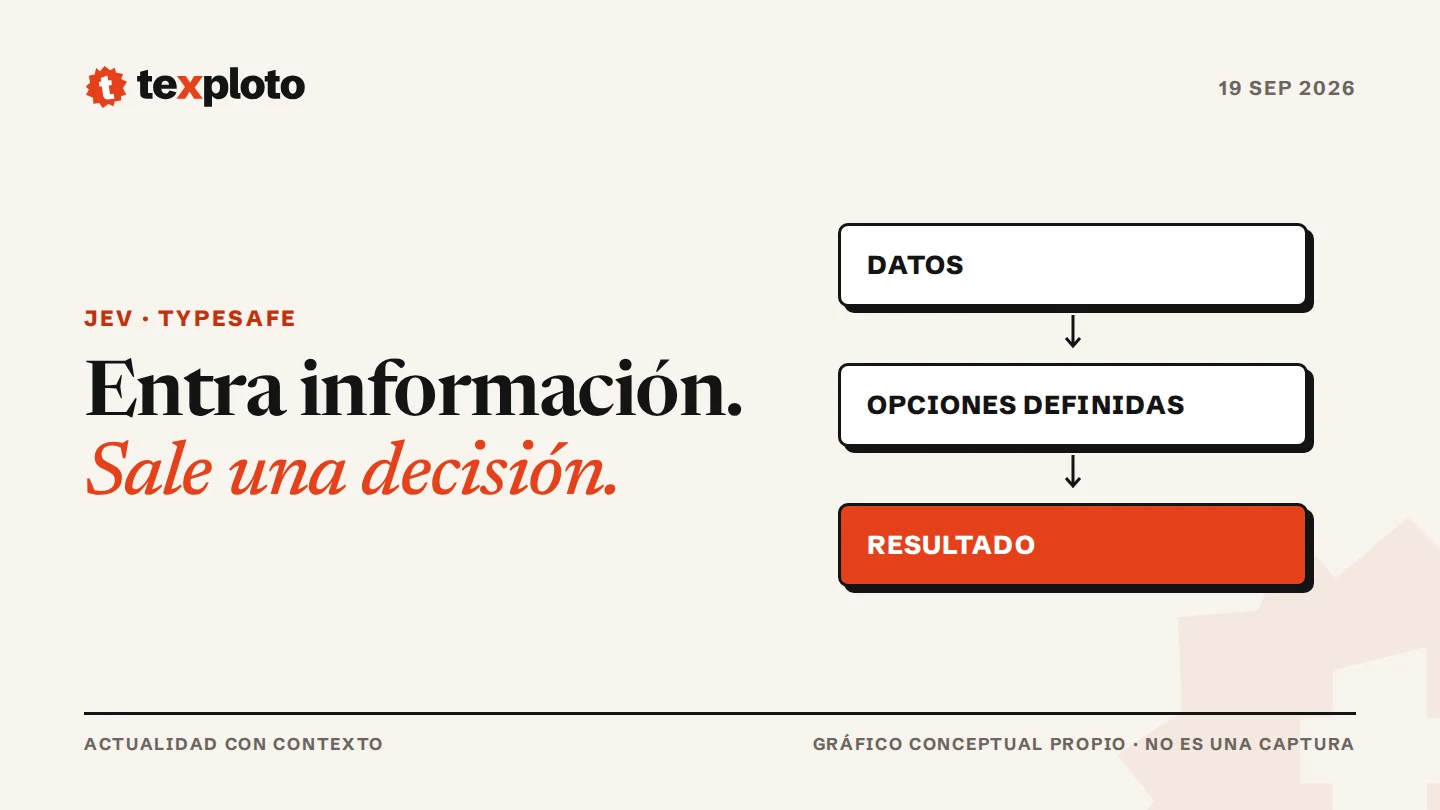
Muchas aplicaciones necesitan clasificar un mensaje o elegir entre varias acciones, sin mantener una conversación. Jev, presentado por TypeSafe el 15 de septiembre, se dirige a ese trabajo: recibe información y preguntas con respuestas definidas, y devuelve resultados estructurados.
El anuncio original lo sitúa en acceso anticipado. La web conserva una lista de espera; no damos por hecho que cualquier cuenta pueda utilizarlo inmediatamente.
Qué devuelve exactamente
La documentación de TypeSafe distingue tres tipos de pregunta: Choice, para elegir una opción; Score, para puntuar según criterios; y Noul, que devuelve un valor entre cero y uno sobre la veracidad de una afirmación.
Choice y Score incluyen probabilidades y un campo de confianza. Según la explicación de confidence, este último resume cómo se distribuyen las probabilidades; no es otra respuesta independiente. Noul no incorpora ese campo.
Un caso sencillo: ordenar peticiones de soporte
Diseño propuesto, no una prueba ejecutada
Una aplicación recibe mensajes y debe clasificarlos en «acceso», «facturación», «error técnico» o «revisión manual». El modelo propone una categoría; el programa decide a qué bandeja enviarlos.
Incluye casos ambiguos desde el principio. «No puedo entrar y me han cobrado» mezcla dos asuntos. Si solo permites una etiqueta y nunca revisas los mensajes dudosos, estarás trasladando esa ambigüedad al equipo que los recibe.
Antes de automatizar, reúne ejemplos ficticios y escribe cómo los clasificarías. Comprueba por separado cuántos acierta y cuántos deriva a revisión. Un sistema que deriva todo podría cometer pocos errores automáticos y, a la vez, ahorrar muy poco trabajo.
Un resultado válido puede estar equivocado
TypeSafe afirma que Jev garantiza el ajuste al esquema y utiliza esa propiedad para explicar su promesa de evitar alucinaciones. Eso no equivale a demostrar que toda clasificación sea correcta. Una etiqueta admitida por el programa puede no corresponder al mensaje.
También las mejoras de velocidad y coste anunciadas proceden de evaluaciones de la empresa. El propio lanzamiento describe condiciones y sesgos posibles. No las presentamos como el ahorro que obtendrá una aplicación concreta.
Nuestra recomendación es revisar dos capas: que la aplicación acepte el resultado y que ese resultado resuelva bien el encargo. Guarda ejemplos donde ambas diverjan; suelen enseñar más que una demostración que solo contiene casos fáciles.
Qué decidir antes de conectarlo a un proceso real
Define qué ocurre si falta información, si la confianza es baja y si el servicio no responde. Puedes mantener la petición en una bandeja de revisión sin ejecutar acciones adicionales. Esa decisión pertenece al diseño de tu aplicación.
Prueba también mensajes distintos que expresen la misma necesidad. Si pequeñas variaciones cambian la categoría sin motivo, necesitas investigar antes de ampliar el uso. Elegir un umbral por intuición no sustituye medir su comportamiento con ejemplos representativos.
Si todavía estás preparando los documentos que alimentarán un flujo, nuestra guía de MarkItDown explica una etapa anterior: convertir archivos a un formato manejable. Preparar el texto y decidir qué hacer con él son tareas diferentes.
Fuentes consultadas el 19/09/2026. No hemos accedido a Jev ni medido latencia, exactitud o costes propios.