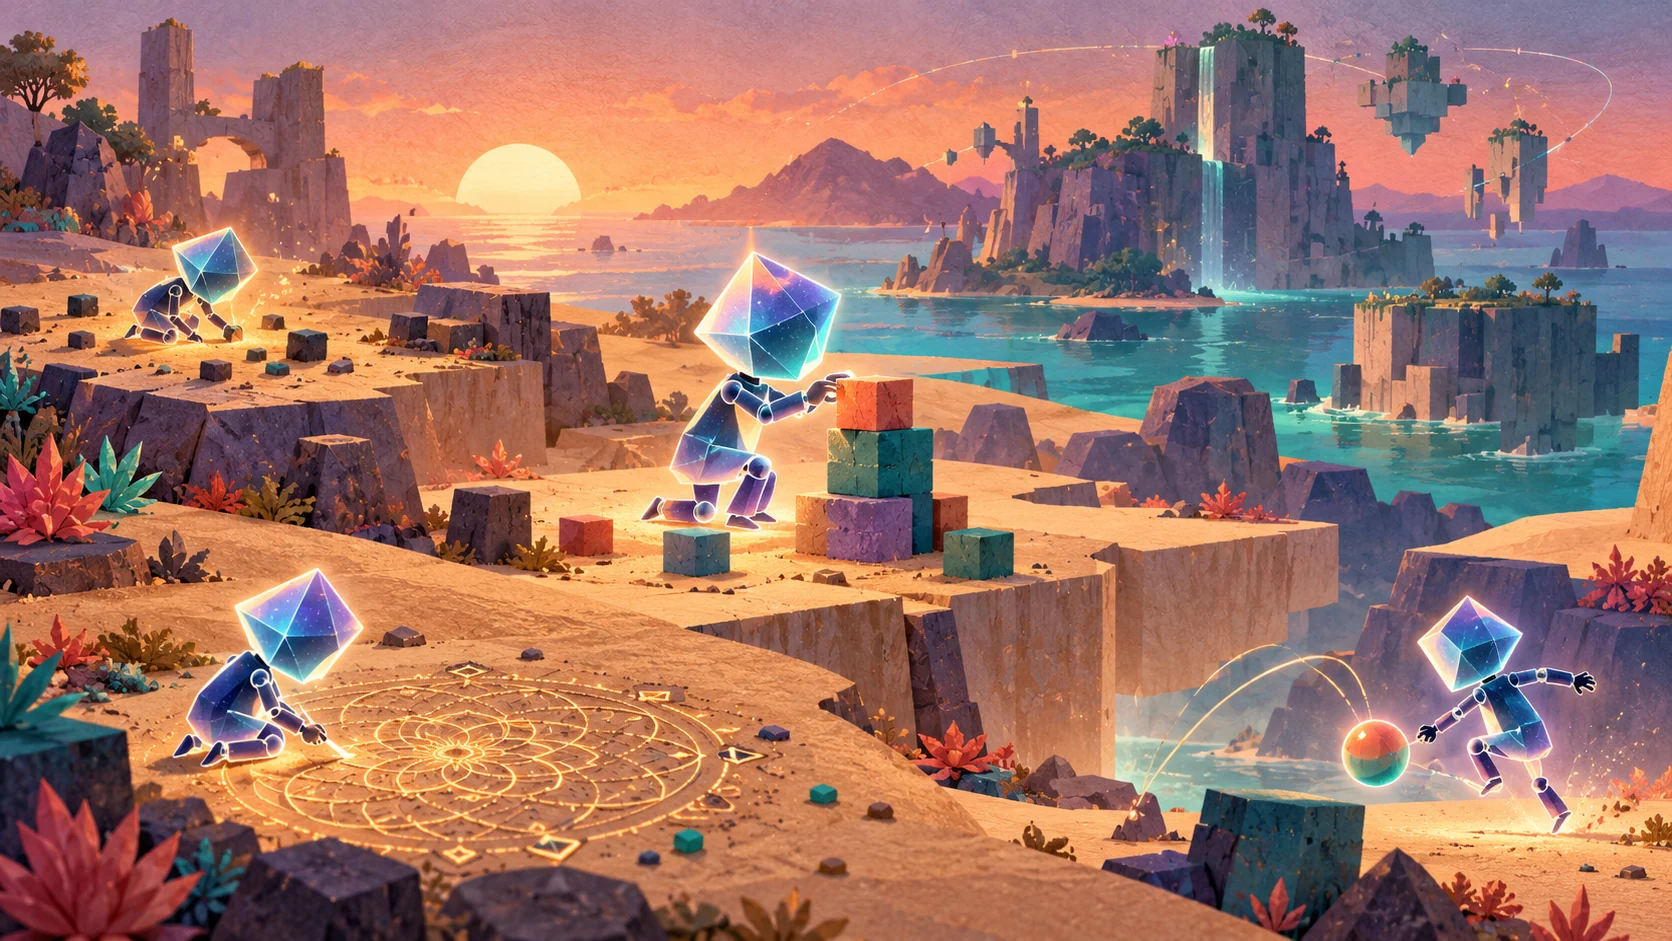
Trece instancias de un agente basado en Claude Opus 4.7 pasaron 30 horas cada una en una isla virtual sin tarea, puntuación ni recompensa explícita. En vez de quedarse quietas, apilaron bloques, dibujaron figuras, inventaron juegos y exploraron la física del entorno. Después, las versiones con esa experiencia superaron a agentes nuevos en tres de cuatro pruebas.
El trabajo «Is this machine playing?», firmado por seis investigadores del MIT, se publicó en arXiv el 5 de octubre y todavía no ha pasado revisión por pares. TechCrunch abrió el estudio y describió el entorno Clawblox, las trece ejecuciones y el coste aproximado de 8.000 dólares en API. La cobertura no convierte el resultado en una réplica independiente.
Qué hicieron y cómo se midió
Cada agente recibió una instrucción mínima para comenzar y una identidad que lo describía como curioso. Podía observar el mundo, mover su cuerpo, manipular bloques y escribir recuerdos en archivos de texto. Las trayectorias fueron distintas, pero reaparecieron conductas como construir torres, recorrer alturas, dibujar mandalas o reinterpretar deportes.
Al terminar, los autores compararon los agentes «con isla» con copias nuevas en cuatro objetivos. Los primeros rindieron mejor en tres. En una tarea de llevar objetos al punto más alto colocaron una media de 10,3 frente a 3,5. El aprendizaje estaba en los recuerdos escritos: al retirar una técnica concreta del archivo, desaparecía la ventaja asociada.
Eso no demuestra curiosidad ni conciencia
El diseño favorecía la exploración: identidad curiosa, herramientas disponibles, un mundo rico y tiempo de cómputo. Que el sistema eligiera actividades no prueba una experiencia subjetiva. La conclusión defendible es más estrecha: una fase sin objetivo externo produjo estrategias reutilizables dentro del mismo entorno.
| Resultado | Qué permite afirmar | Qué no permite afirmar |
|---|---|---|
| Conductas parecidas al juego en 13 ejecuciones | El patrón no fue un caso único | Que todos los agentes jueguen espontáneamente |
| Ventaja en 3 de 4 tareas | La memoria ayudó en ese mundo | Mejora general en razonamiento |
| Técnicas guardadas en texto | Hay un mecanismo inspeccionable | Aprendizaje interno permanente del modelo |
La aportación útil es separar exploración de entrenamiento
El modelo no cambió sus pesos. Lo que mejoró fue el repertorio externo de procedimientos. Para sistemas de agentes, esto sugiere una alternativa a programar cada habilidad: permitir exploración en un entorno controlado y conservar únicamente las estrategias que pasan pruebas posteriores.
Faltan réplicas con otros modelos, mundos y presupuestos, además de una evaluación ciega de qué cuenta como «juego». El nivel de evidencia es un estudio primario no revisado por pares y cobertura periodística de su método, no una validación funcional independiente.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. Texploto no ejecutó el experimento.