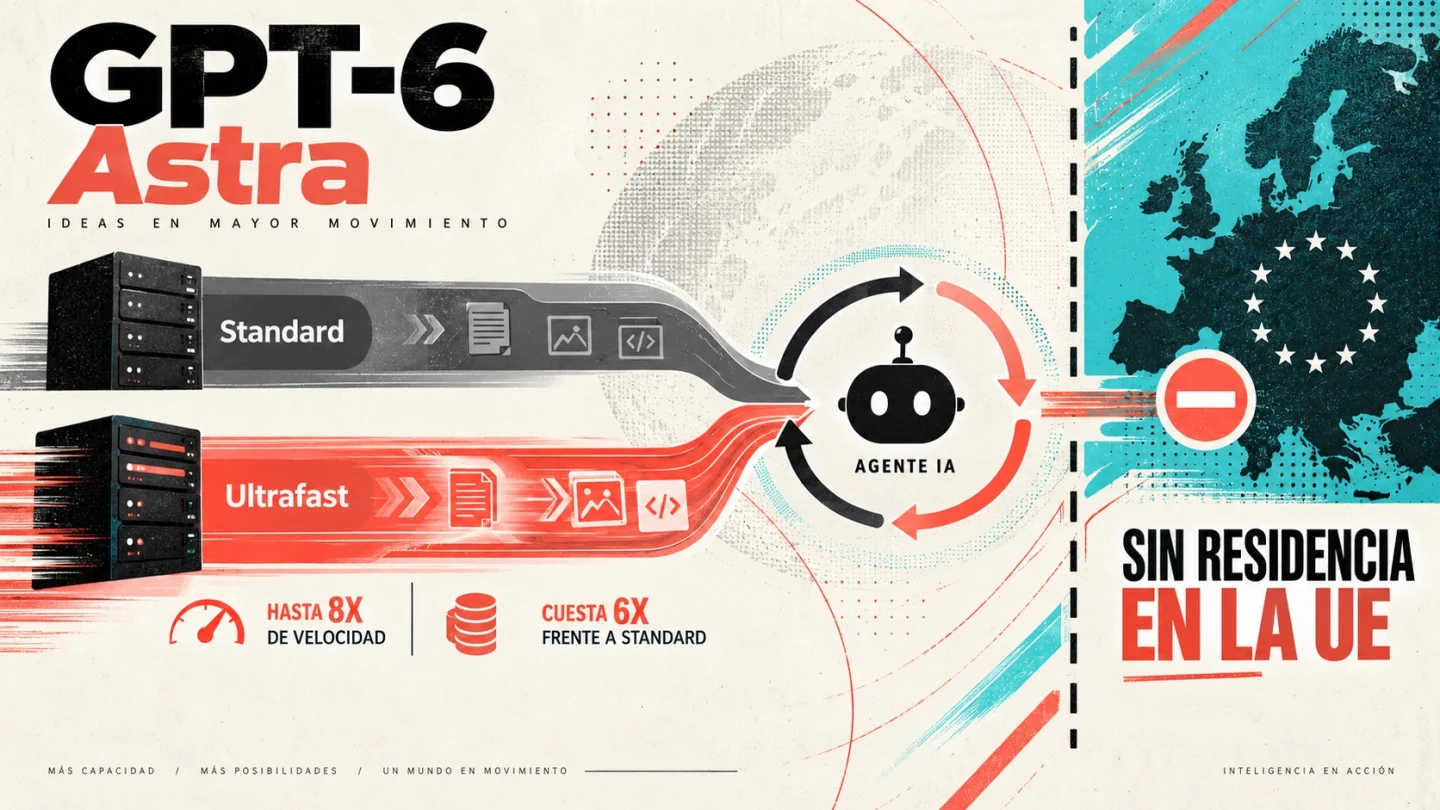
OpenAI ha abierto Ultrafast, su carril más rápido para GPT‑6 Astra, y la cifra llamativa —hasta ocho veces más velocidad que el modo Standard— llega con dos condiciones que importan especialmente en España: cuesta seis veces más en la API y no admite residencia de datos en la Unión Europea.
No es un modelo nuevo ni una mejora automática de calidad. Es el mismo Astra atendido con otra prioridad de servicio. La documentación de OpenAI recomienda conexiones WebSocket persistentes para agentes que encadenan llamadas a herramientas; si cada paso abre una conexión nueva, la latencia de red puede comerse parte de la ventaja.
La tarifa convierte el tiempo en una decisión económica
Para contextos de hasta 272.000 tokens, la tabla publicada cobra 60 dólares por millón de tokens de entrada, 6 por entrada en caché, 75 por escritura de caché y 300 por salida. Standard cuesta 10, 1, 12,50 y 50 dólares respectivamente. Por encima de ese umbral, toda la solicitud pasa a la tarifa larga: Ultrafast sube a 120 dólares de entrada y 450 de salida.
La comparación correcta no es «ocho veces más rápido por seis veces más dinero» para cualquier tarea. OpenAI habla de hasta ocho veces y NVIDIA atribuye esa aceleración a optimizaciones de inferencia sobre GPU Blackwell. El resultado depende del tamaño de la entrada, la longitud de la respuesta, las herramientas y la red.
Un ejemplo puramente aritmético ayuda a fijar el orden de magnitud. Una ejecución con 100.000 tokens de entrada y 20.000 de salida cuesta unos 2 dólares en Standard y 12 en Ultrafast, antes de caché y herramientas. Ahorrar unos minutos puede justificar diez dólares si hay una persona o un sistema crítico esperando; no los justifica en un resumen nocturno sin usuario bloqueado.
Cuándo la latencia sí forma parte del producto
El carril rápido encaja mejor en bucles secuenciales. Un agente que edita, ejecuta una prueba, interpreta el resultado y vuelve a editar no puede paralelizar todos los pasos: cada respuesta desbloquea la siguiente. También puede tener sentido en asistencia en directo o control visual, donde una pausa larga rompe la interacción.
En cambio, para clasificación masiva, generación de informes, evaluaciones o tareas que pueden esperar, Batch y Flex persiguen el objetivo opuesto: menor coste a cambio de menos urgencia. GPT‑6.1 Sol, analizado ayer en Texploto, ofrece además una vía de menor precio cuando no hace falta la capacidad máxima de Astra.
Una prueba útil necesita medir entrega, no tokens por segundo
Antes de cambiar un flujo conviene registrar cuatro magnitudes en las mismas tareas: tiempo hasta el primer resultado útil, tiempo total hasta aceptación, coste completo y porcentaje de ejecuciones que requieren corrección. Una salida rápida pero equivocada puede consumir el ahorro en el siguiente ciclo.
NVIDIA afirma que Ultrafast acelera hasta ocho veces la generación en Codex y que OpenAI usa sus propios modelos para optimizar el software de inferencia. Son datos de los proveedores. No encontramos aún un benchmark independiente sustancial del nuevo carril que repita esas cifras con metodología pública.
La limitación regional es más concreta. OpenAI documenta procesamiento global y residencia estadounidense, pero no puntos de procesamiento regionales de la UE. Una empresa que deba mantener datos europeos no debería interpretar «disponible en la API» como «compatible con su política de residencia».
Nivel de evidencia: documentación/fuente primaria y explicación del fabricante, sin prueba independiente publicada del modo Ultrafast. No hemos ejecutado el servicio.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. No se han ejecutado los productos o sistemas descritos.