La idea clave
MarkItDown convierte bien hojas de cálculo, presentaciones y tablas en PDF, y lo hace sin conectarse a internet. Pero con un PDF escaneado devuelve un archivo vacío como si todo hubiera ido bien, no limpia las páginas web y en Word pierde parte de la estructura. Úsalo, pero comprueba siempre la salida.
Hemos instalado MarkItDown desde cero y le hemos pasado seis documentos cuyo contenido conocemos al detalle. Para cada uno definimos antes qué debía conservar una conversión fiel y lo comprobamos después. Aquí están los resultados, las capturas sin editar y los datos para que puedas repetir la prueba.
Qué es MarkItDown y para qué sirve
MarkItDown es una herramienta de código abierto de Microsoft que convierte PDF, Word, Excel, PowerPoint, HTML y otros formatos a Markdown. Tiene licencia MIT y, cuando la probamos, superaba las 187.000 estrellas en GitHub.
Markdown es texto plano con marcas sencillas para títulos, listas y tablas. Los modelos de IA lo entienden muy bien y no gastan espacio en maquetación. Por eso MarkItDown se usa sobre todo para preparar documentos antes de pasárselos a ChatGPT, Claude o a un agente propio. Si solo quieres saber qué hace y cómo instalarlo, tienes nuestra guía de MarkItDown. Este artículo responde a otra pregunta: qué conserva de verdad cuando lo usas.
Cómo lo hemos probado
- Versión: MarkItDown 0.1.8 instalado desde PyPI. Código revisado en el commit
b8f79c5del 21 de septiembre de 2026. - Equipo: Linux, 2 núcleos, 7,8 GB de RAM, sin tarjeta gráfica y Python 3.11. Un entorno limpio, creado solo para esta prueba y borrado al terminar.
- Documentos: un informe en Word con tabla, listas, enlace e imagen; una hoja de Excel con fórmulas y dos pestañas; una presentación con notas del ponente; una página web con menú, banner publicitario y pie legal; una factura en PDF y un contrato escaneado. Los creamos nosotros para saber exactamente qué contienen.
- Criterio: antes de ejecutar nada, anotamos para cada documento qué elementos debían aparecer en una conversión fiel (títulos, negritas, tablas, enlaces, cifras…). En la web, además, qué debía desaparecer: menú, publicidad y pie. Después un script lo comprueba en la salida, sin interpretación.
- Seguridad: antes de instalarlo revisamos el código en busca de scripts de instalación, telemetría y conexiones de red. No encontramos nada preocupante. Los detalles están en los datos de la prueba.
La prueba la ha ejecutado un agente de IA en ese entorno aislado, siguiendo el protocolo del Laboratorio, y la ha revisado la redacción. Las capturas son salidas reales sin editar: el marco solo añade el contexto.
Descarga los datos de la prueba: documentos, salidas, registros completos y el script que la repite de principio a fin, en un único archivo ZIP.
Resultados, documento a documento
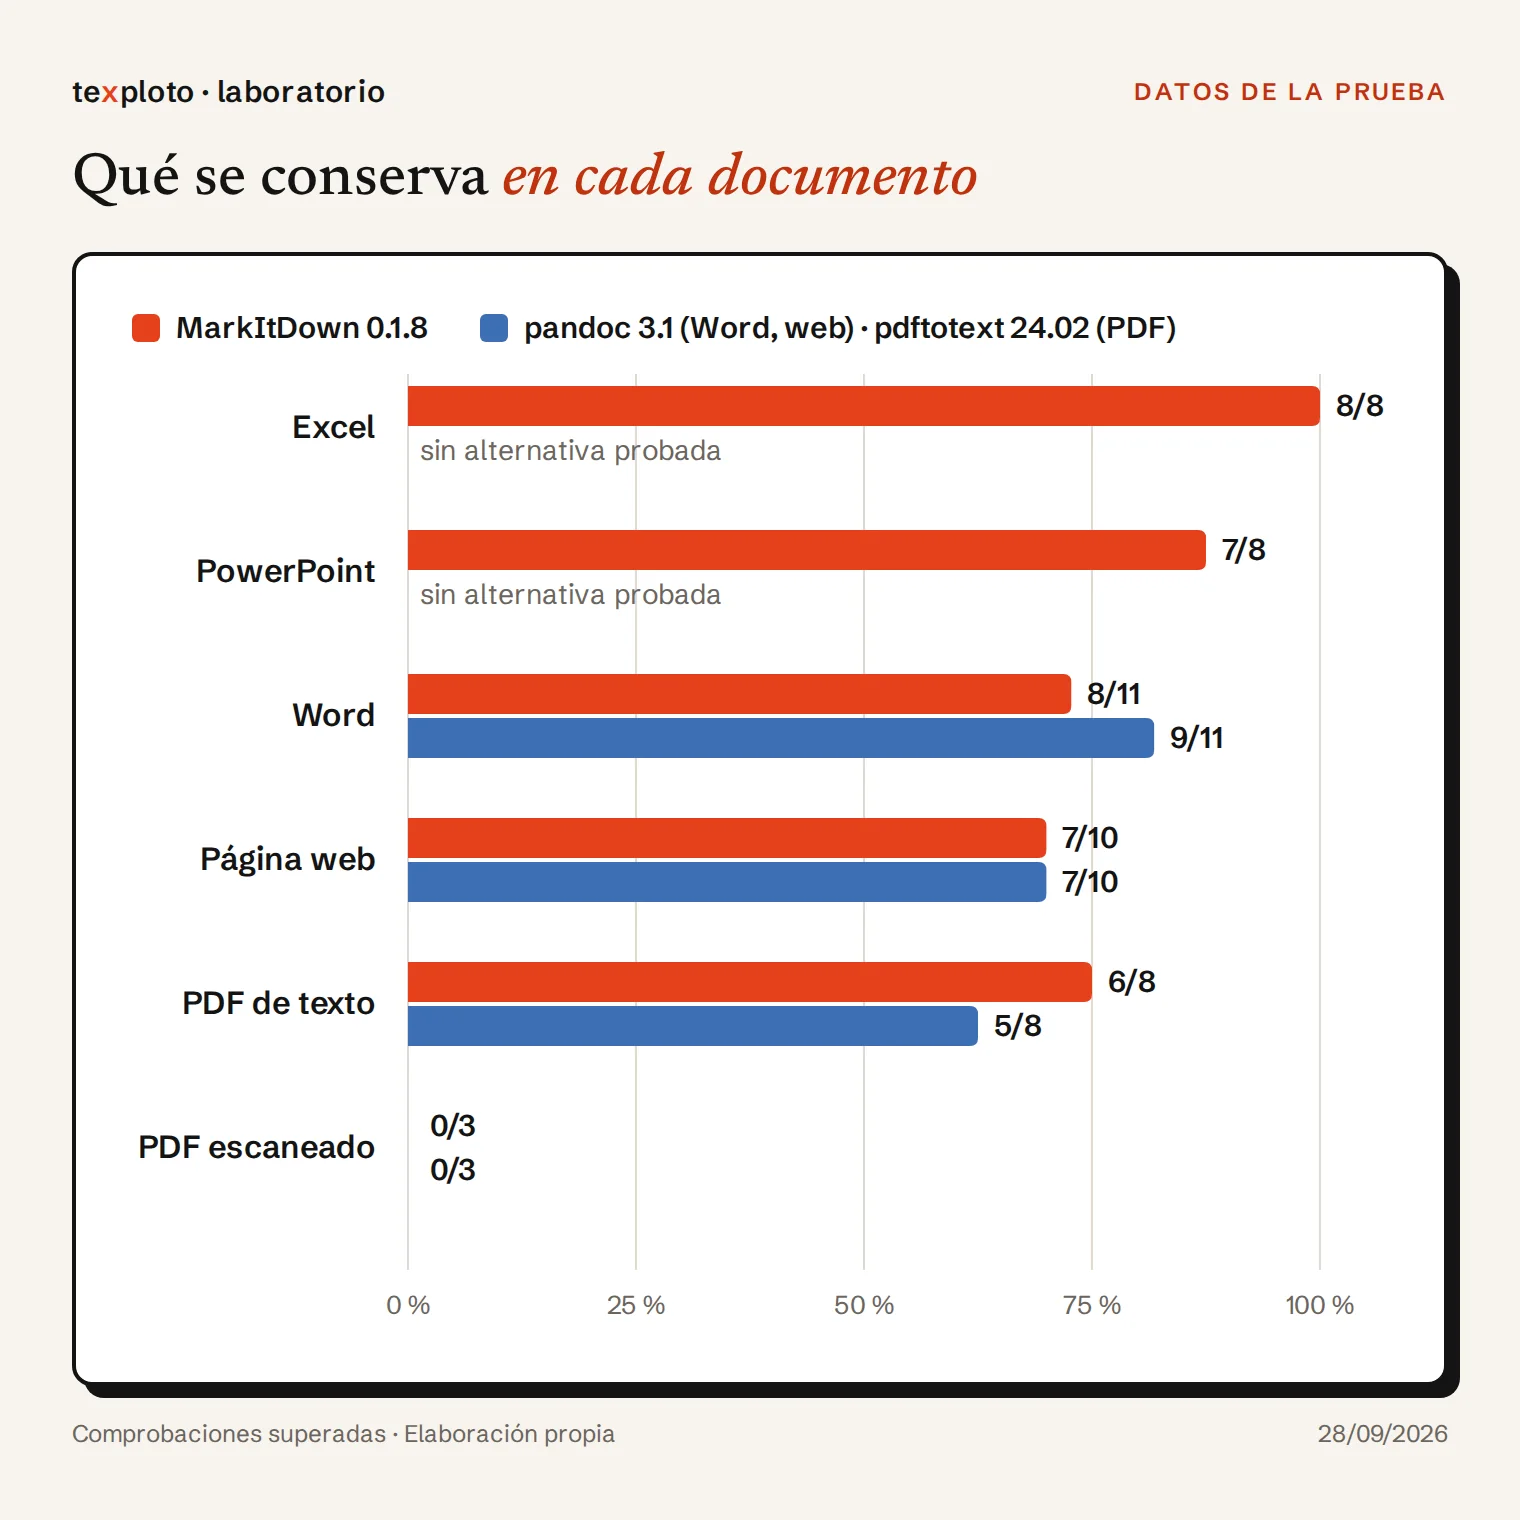
| Documento | Se conserva | Lo que falla |
|---|---|---|
| Excel | 8/8 | Nada relevante. Las celdas vacías aparecen como NaN |
| PowerPoint | 7/8 | Las viñetas salen como líneas sueltas, no como lista |
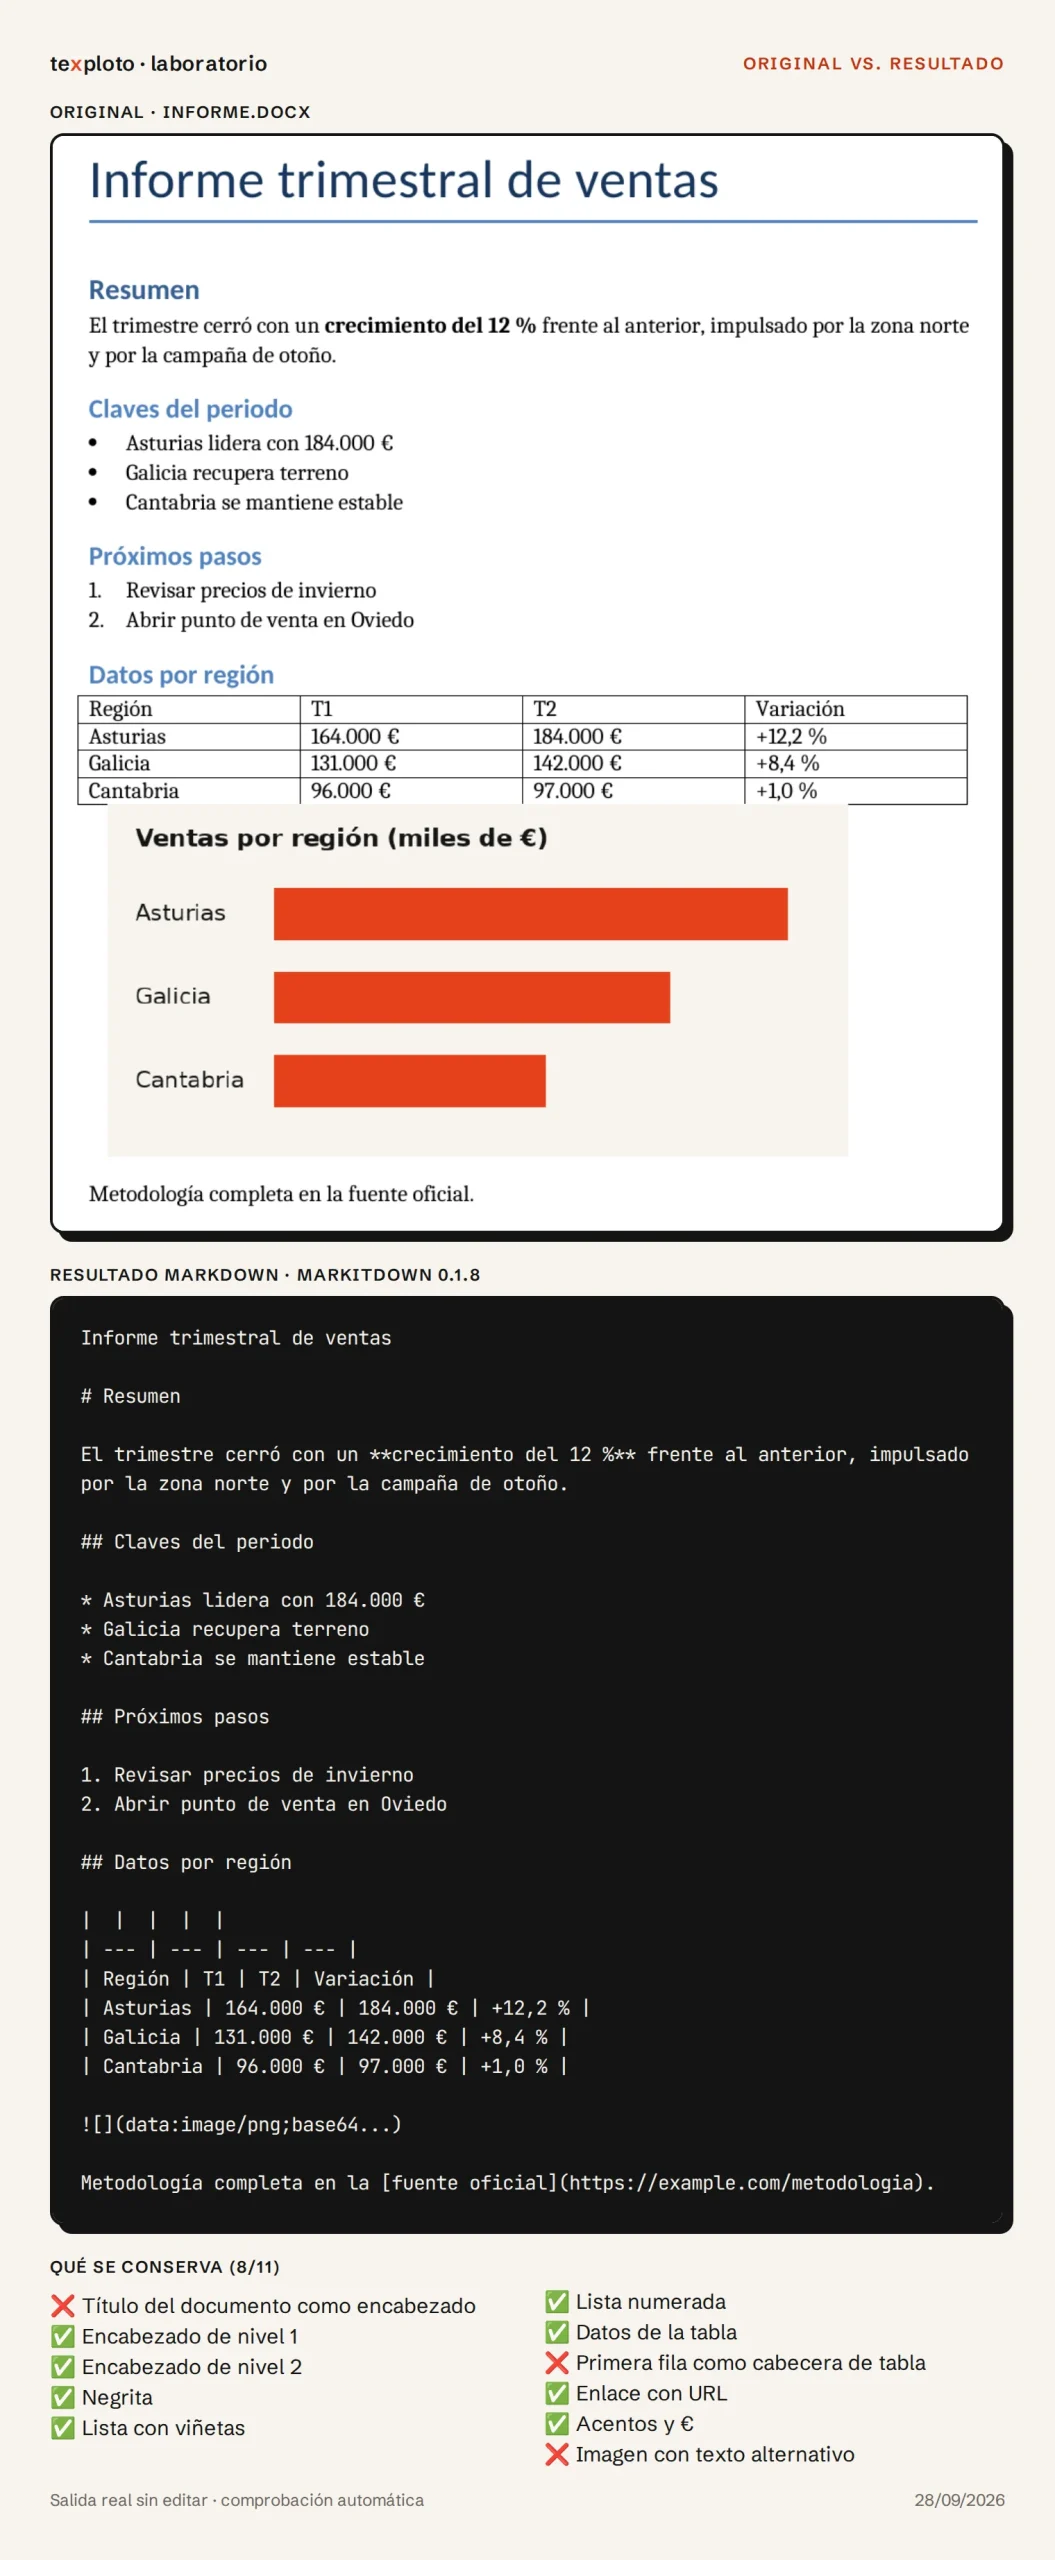
| Word | 8/11 | El título del documento, la cabecera de la tabla y el contenido de la imagen |
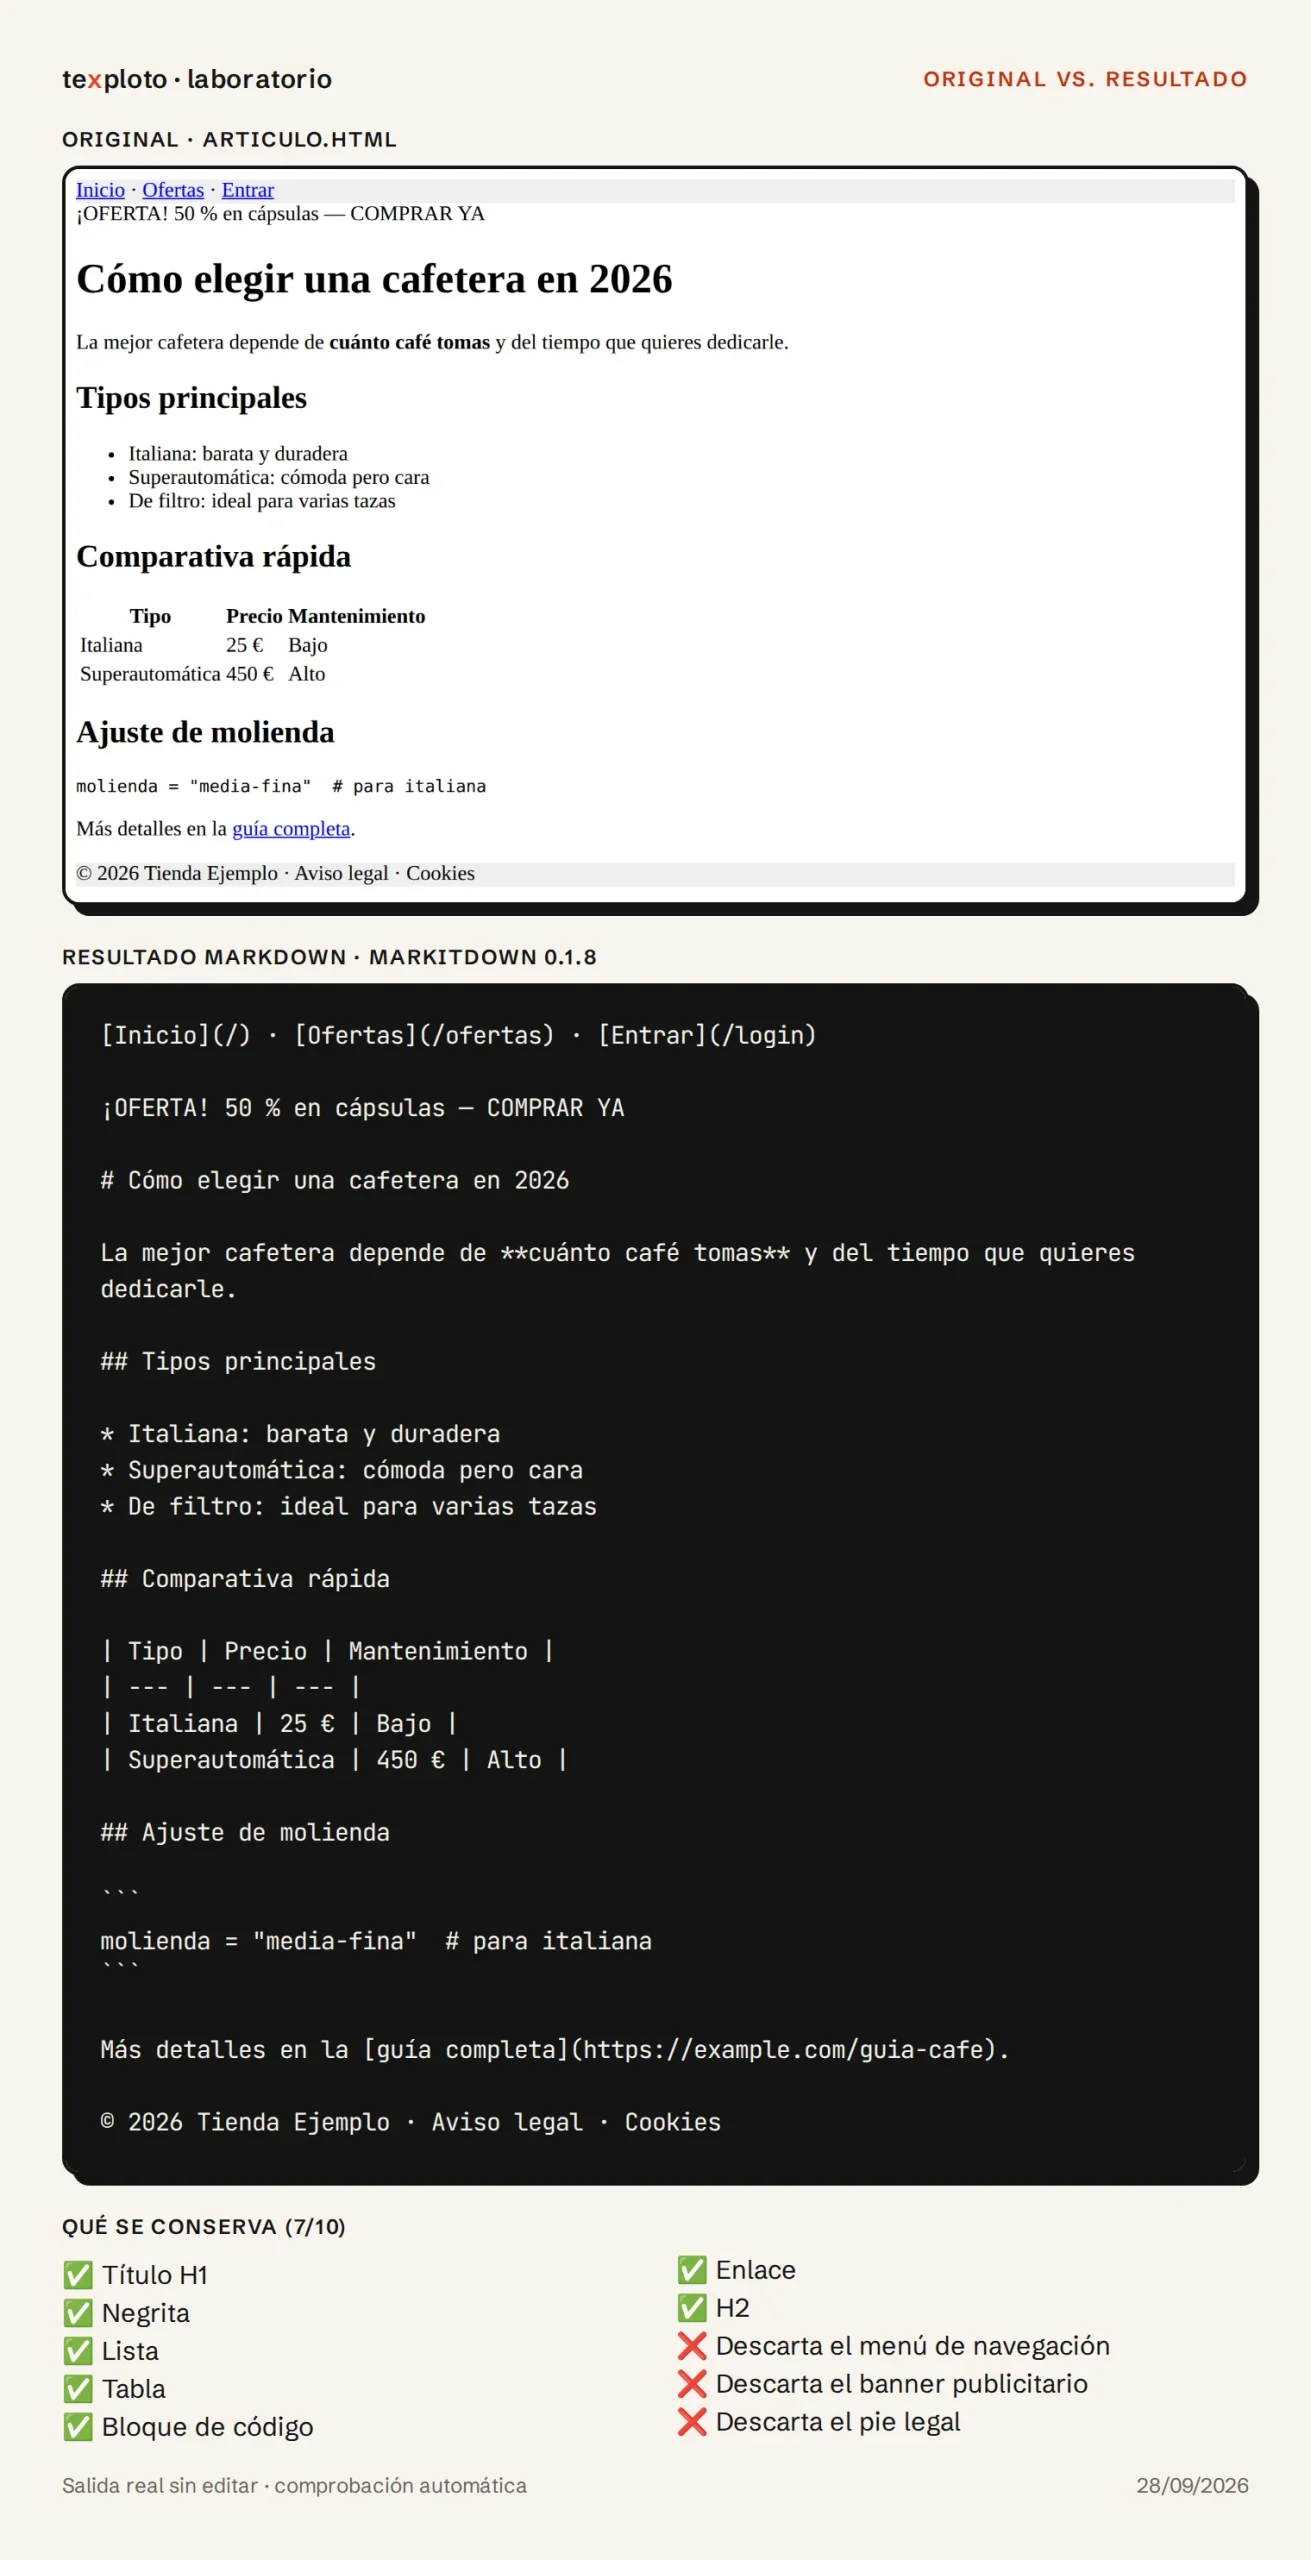
| Página web | 7/10 | Todo el contenido bien, pero mantiene el menú, la publicidad y el pie legal |
| PDF de texto | 6/8 | Tabla perfecta, pero sin títulos ni negritas |
| PDF escaneado | 0/3 | Salida vacía, y el programa termina sin avisar de ningún error |
Lo que hace bien
Las hojas de cálculo llegan completas, con los resultados de las fórmulas
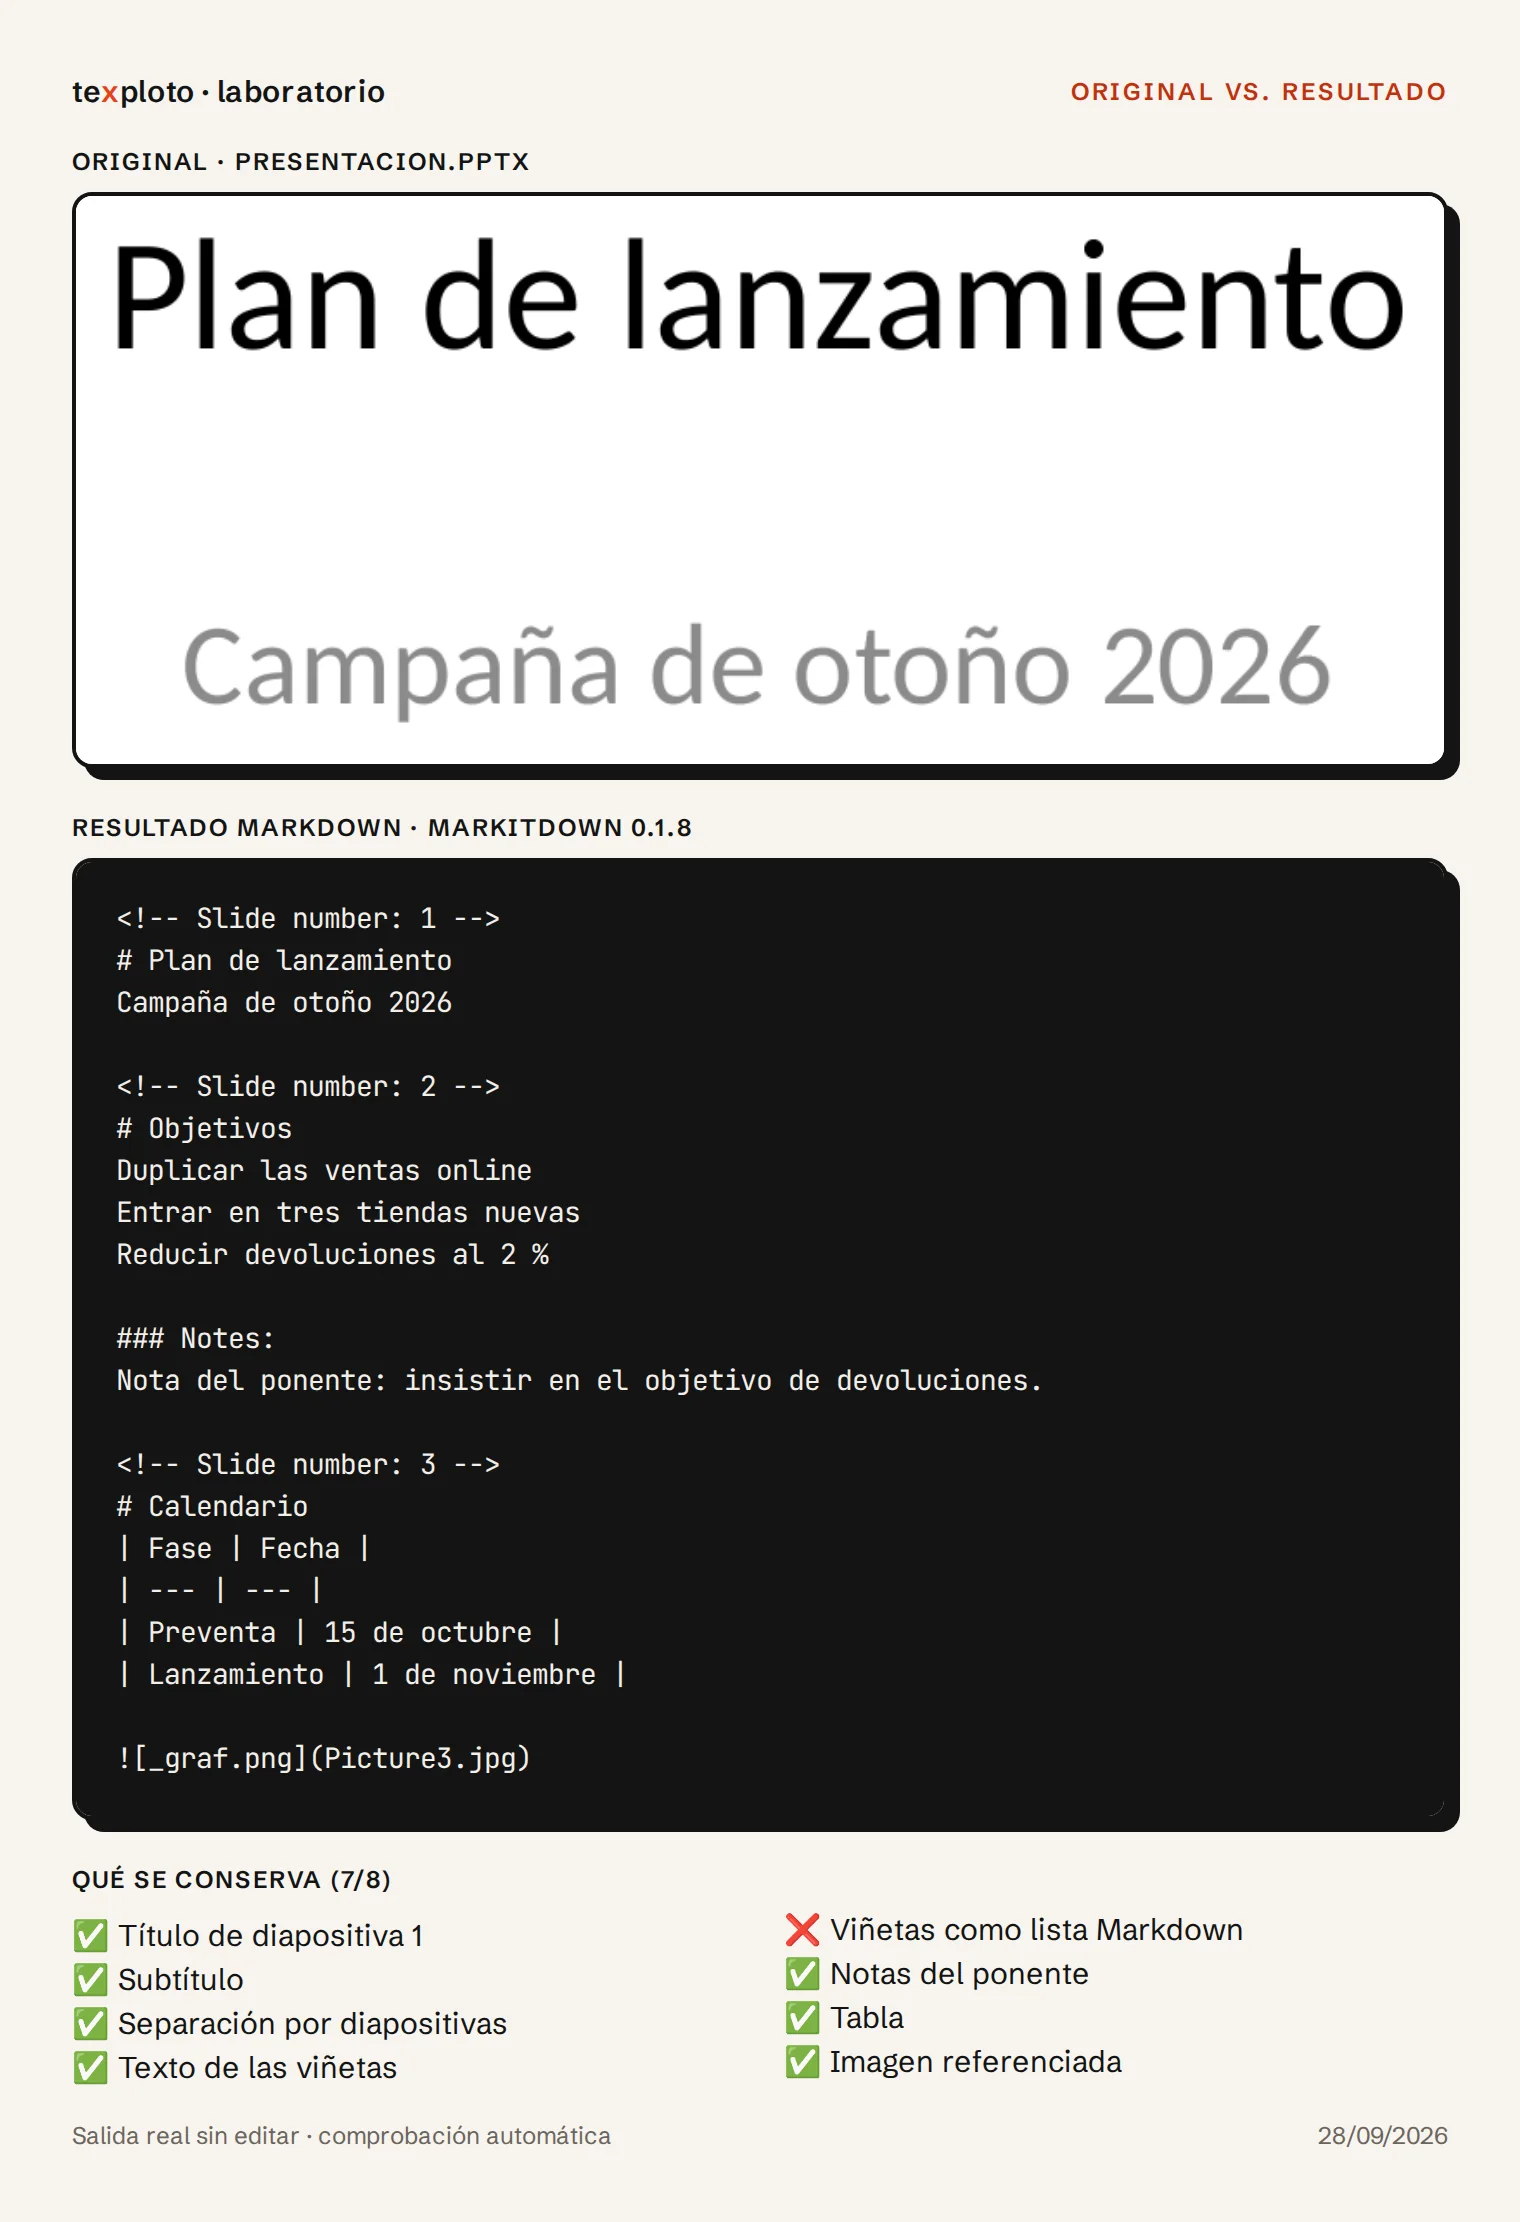
Es su punto fuerte. Cada pestaña del Excel se convierte en una sección con su propia tabla. Las fórmulas llegan con su resultado (3.330 unidades y 15.189 € en los totales), no como =SUM(B2:B6). Así una IA puede trabajar con los números sin que tengas que exportar nada antes. El texto de la celda combinada de la segunda pestaña también aparece.
Las presentaciones mantienen el orden y las notas del ponente
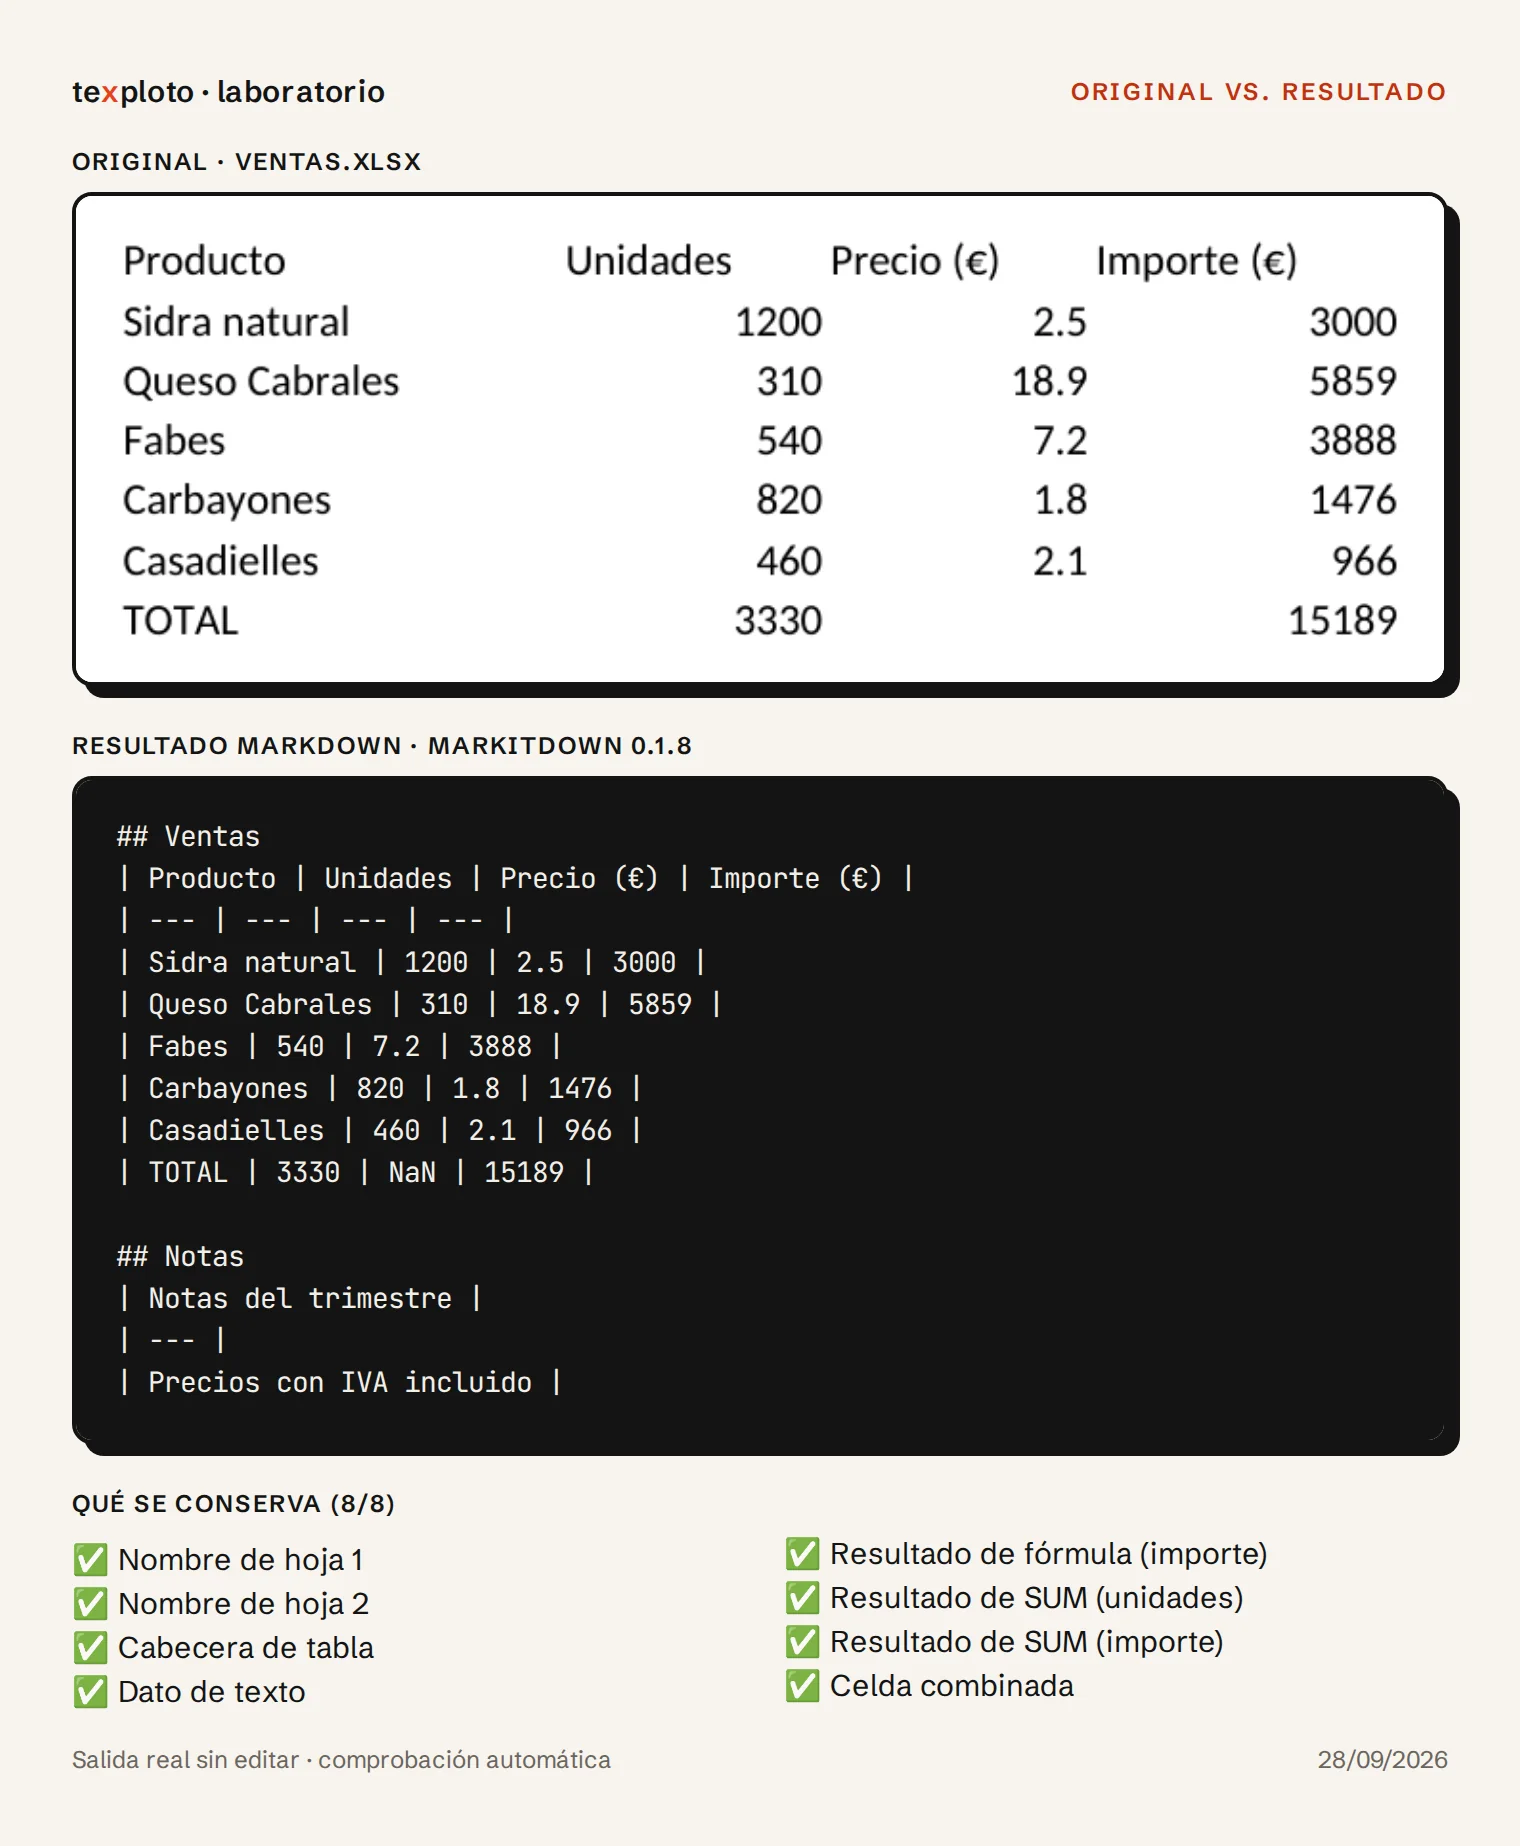
Cada diapositiva queda marcada con su número. El título pasa a encabezado y la tabla del calendario se convierte en una tabla Markdown. Además incluye las notas del ponente, que a menudo tienen el contexto más útil de una presentación. Lo único que falla es que las viñetas salen como líneas de texto sin marcar como lista.
Las tablas de un PDF de texto salen con sus columnas
En la factura reconstruye la tabla de conceptos con sus cuatro columnas y los importes en su sitio. Para pasarle facturas o informes a una IA, eso es lo que más importa. Lo que pierde es la jerarquía: el título y la palabra «Total», que estaba en negrita, salen como texto normal.
No se conecta a internet
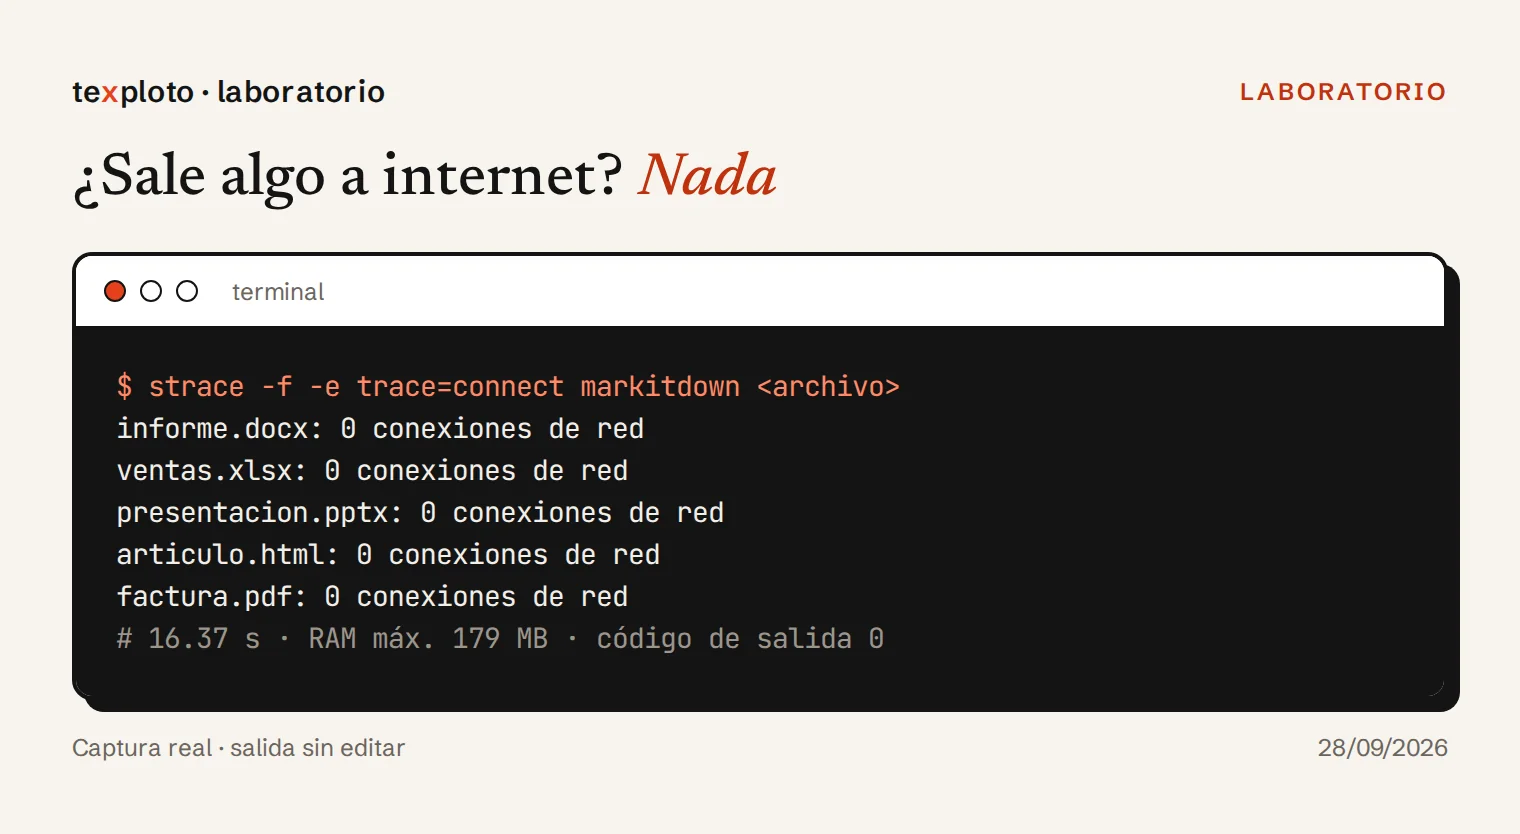
Registramos cada intento de conexión de red mientras convertía los cinco documentos locales, y no hubo ninguno. La revisión del código lo confirma: solo se conecta si activas funciones opcionales, como convertir una URL o un vídeo de YouTube, usar los servicios de Azure o pedir a un modelo de IA que describa imágenes. Si trabajas con contratos o datos de clientes, puedes convertirlos sin que salgan de tu equipo.
Es rápido, sobre todo desde Python
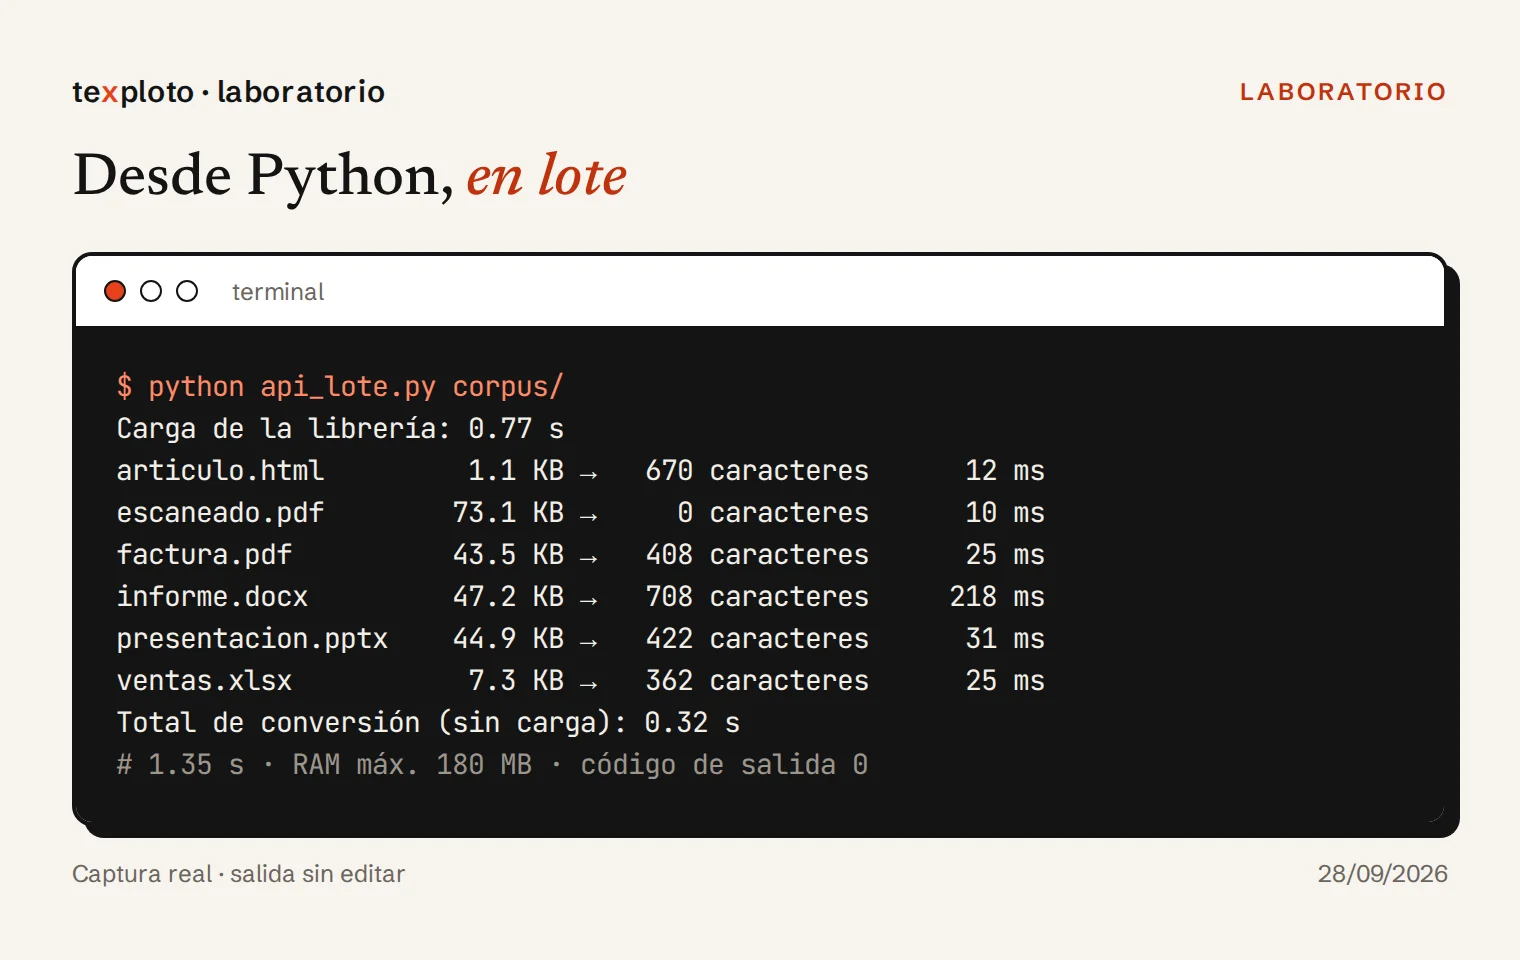
Desde la terminal tarda alrededor de un segundo por archivo, pero casi todo ese tiempo es arranque. Usado desde Python, la librería carga en menos de un segundo y convierte los seis documentos en unos 0,3 segundos en total. El más lento fue el Word, con unos 200 milisegundos. Usó unos 180 MB de memoria como máximo.
Cuatro problemas que conviene conocer
1. Con un PDF escaneado devuelve un archivo vacío y no avisa
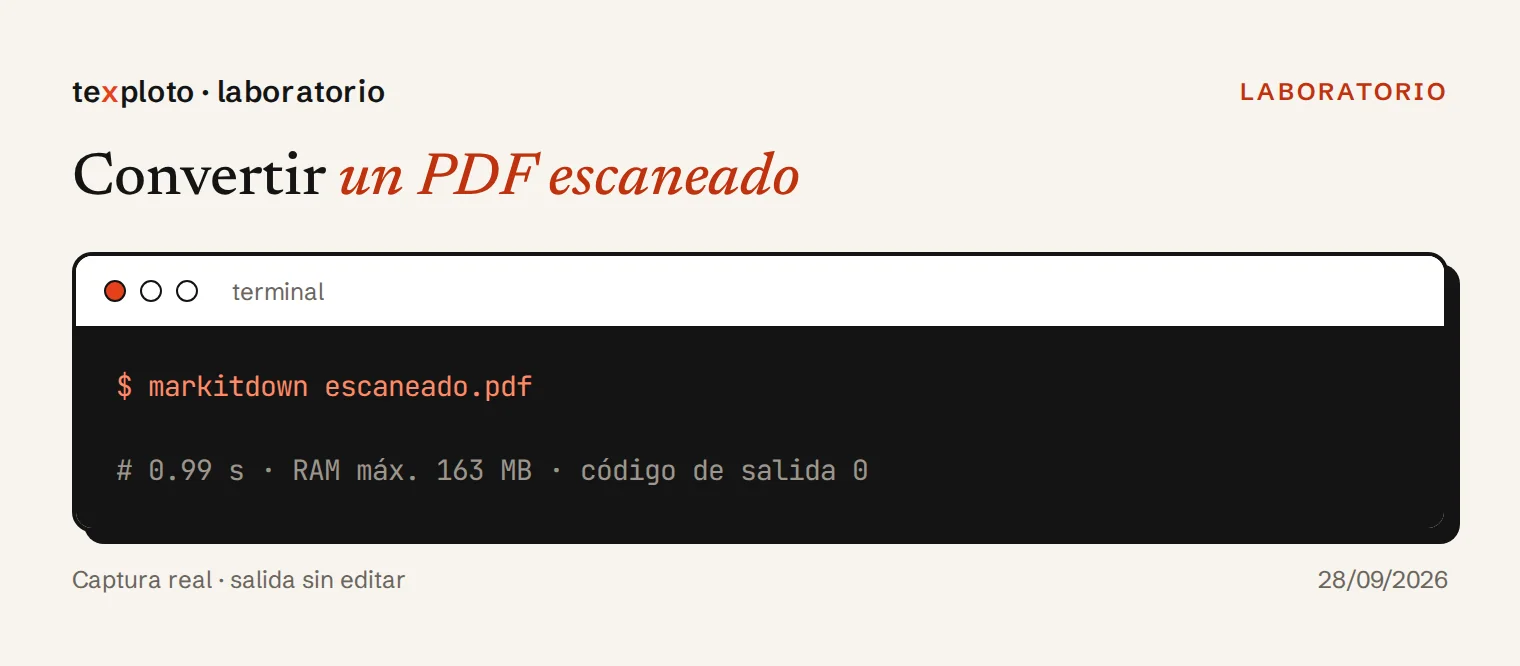
Es el hallazgo más importante de la prueba. Si el PDF es una imagen, como un contrato escaneado o la foto de un documento, MarkItDown genera un archivo vacío y termina con código de salida 0, es decir, sin ningún error. Si lo usas en un proceso automático, podrías estar pasando documentos vacíos a tu IA sin enterarte. Y la IA respondería sin haber leído nada.
Para leer escaneados, el proyecto ofrece el complemento markitdown-ocr, que usa un modelo de IA con visión (por ejemplo, de OpenAI) y por tanto una clave de API de pago. Según su documentación, si no le das un modelo, se salta el OCR sin avisar. No lo hemos probado todavía.
2. No limpia las páginas web
Convierte todo el HTML: el contenido sale bien, pero también el menú de navegación, el banner de oferta y el pie legal. Para un modelo de IA es ruido que ocupa espacio y puede confundirle. Más abajo tienes un fragmento para quedarte solo con el artículo.
3. En Word pierde parte de la estructura
El título del documento (el estilo «Título» de Word) sale como texto normal. En la tabla, la primera fila no se reconoce como cabecera: aparece una cabecera vacía y los nombres de las columnas como si fueran datos. Una IA lo entiende igualmente, pero si vas a reutilizar el Markdown tendrás que corregirlo a mano. La imagen se sustituye por un marcador sin contenido. Con la opción --keep-data-uris se incluye entera, codificada en base64: en nuestro informe, el resultado pasó de 708 caracteres a más de 17.000.
4. La instalación completa pesa más de lo que parece
El README recomienda pip install 'markitdown[all]'. En nuestra prueba instaló 51 paquetes, ocupó 423 MB y tardó algo más de 20 segundos. Incluye los SDK de Azure y el reconocimiento de voz, que la mayoría no usará. La instalación mínima para oficina y PDF (markitdown[pdf,docx,xlsx,pptx]) se queda en 38 paquetes y 367 MB. El grueso lo ponen pandas, numpy y el pequeño modelo que usa para detectar el tipo de archivo.
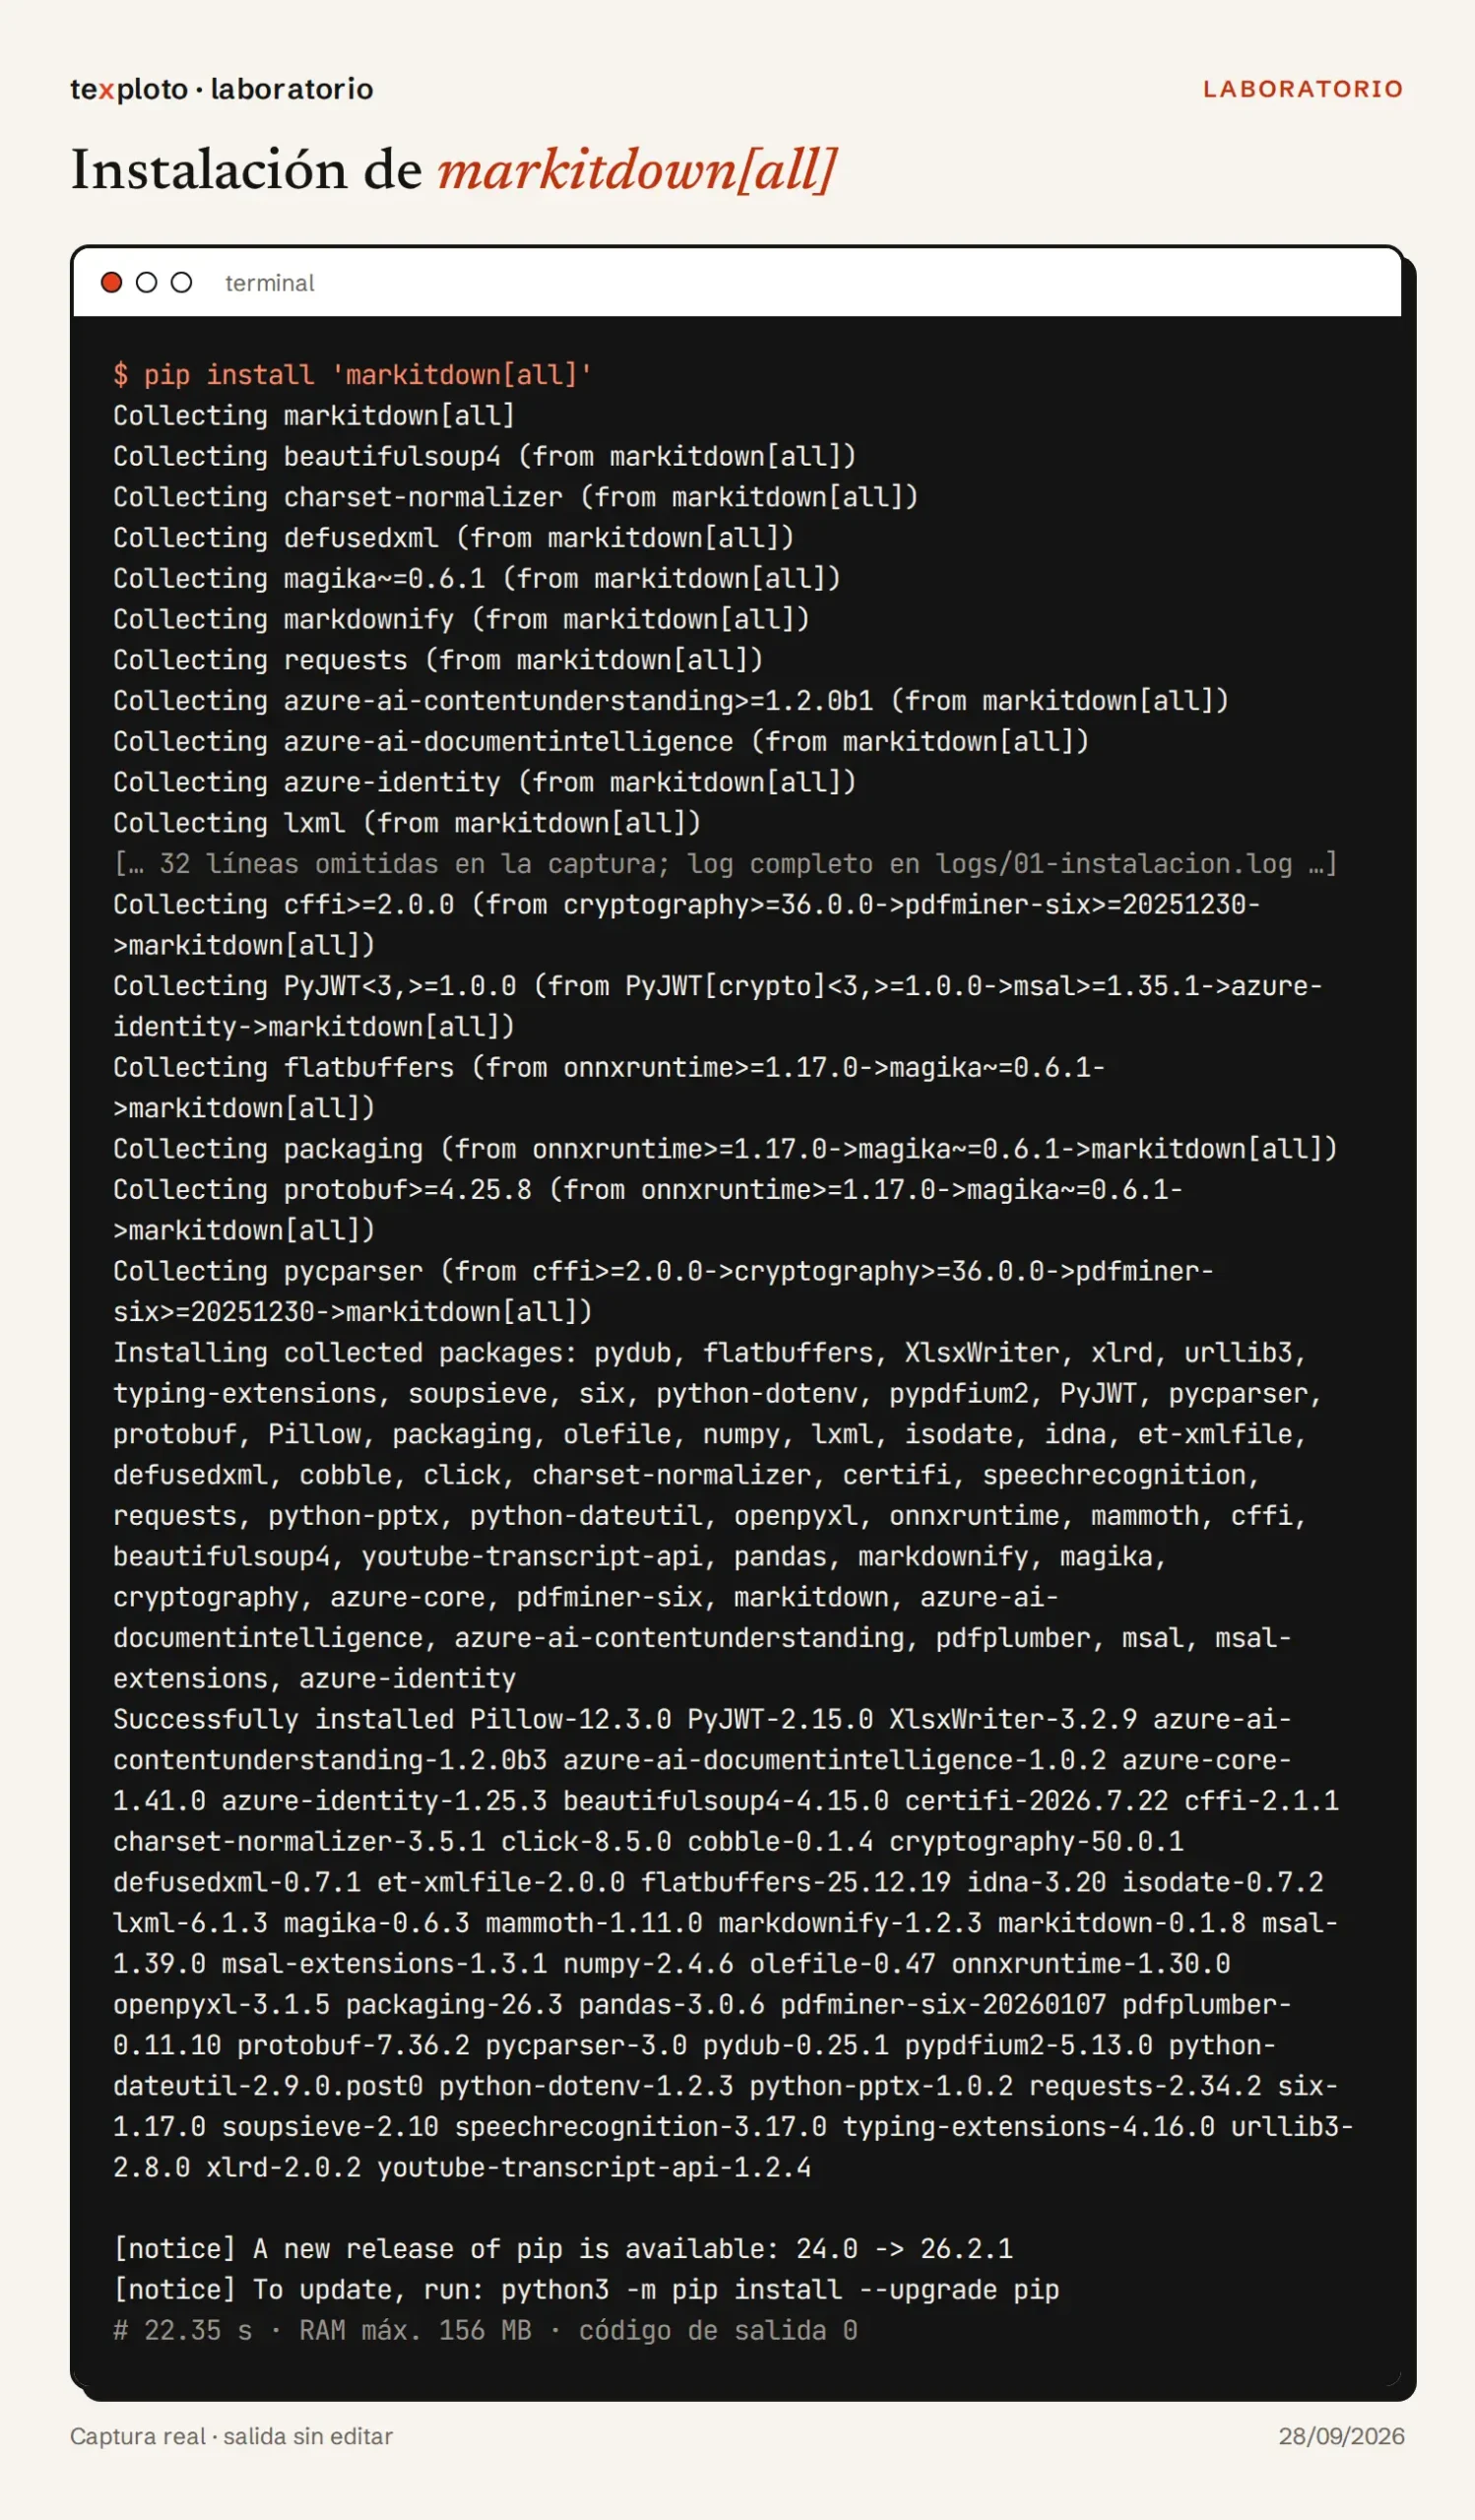
markitdown[all]: 51 paquetes.¿Y pandoc o pdftotext?
Pasamos los mismos documentos, con el mismo criterio, por dos herramientas clásicas que quizá ya tengas instaladas: pandoc 3.1 para Word y web, y pdftotext 24.02 para los PDF.
| Documento | MarkItDown | Alternativa | Diferencia clave |
|---|---|---|---|
| Word | 8/11 | pandoc: 9/11 | pandoc reconoce la cabecera de la tabla, pero borra el título del documento si no añades -s |
| Página web | 7/10 | pandoc: 7/10 | Empate: ninguno quita el menú ni la publicidad. pandoc deja además restos de HTML |
| PDF de texto | 6/8 | pdftotext: 5/8 | pdftotext conserva el texto, pero la tabla queda como columnas alineadas con espacios, no como tabla Markdown |
| PDF escaneado | 0/3 | pdftotext: 0/3 | Ninguno lee escaneados sin OCR |
Conclusión: para un Word o una web sueltos, pandoc hace un trabajo parecido y es más ligero. La ventaja de MarkItDown está en tener una sola herramienta para todo, con Excel y PowerPoint incluidos (pandoc 3.1 no los lee), y en las tablas de los PDF. No hemos probado otras opciones más pesadas, como Docling.
¿Para quién es?
| Te sirve si… | Busca otra opción si… |
|---|---|
| Quieres pasar Excel, PowerPoint o PDF con tablas a ChatGPT, Claude o tu propio agente | Trabajas sobre todo con documentos escaneados o fotos |
| Necesitas que los documentos no salgan de tu equipo | Necesitas conservar el formato exacto para volver a maquetar |
| Montas un proceso automático en Python con varios formatos | Vas a leer páginas web y solo quieres el artículo, sin recortarlo antes |
Cómo empezar sin sustos
1. Instala solo lo que vas a usar. Necesitas Python 3.10 o superior. Te ahorras paquetes y descargas:
python3 -m venv .venv
.venv/bin/pip install 'markitdown[pdf,docx,xlsx,pptx]'
.venv/bin/markitdown informe.xlsx -o informe.md
En Windows, usa .venv\Scripts\pip y .venv\Scripts\markitdown. No lo hemos probado en Windows.
2. Comprueba que la salida no está vacía. Es la defensa contra el problema de los escaneados. Hemos ejecutado este fragmento con los documentos de la prueba: convierte la factura y avisa con el contrato escaneado.
from markitdown import MarkItDown

md = MarkItDown()

def convertir(ruta):
    texto = md.convert(ruta).text_content
    if not texto.strip():
        raise ValueError(f"{ruta}: conversión vacía (¿PDF escaneado o imagen?)")
    return texto
3. En páginas web, quédate con el contenido principal. Este fragmento extrae solo la etiqueta <article> antes de convertir. Con nuestra página de prueba desaparecen el menú, el banner y el pie, y el resto se mantiene igual. BeautifulSoup ya se instala con MarkItDown.
import io
from bs4 import BeautifulSoup
from markitdown import MarkItDown, StreamInfo

html = open("pagina.html", encoding="utf-8").read()
principal = BeautifulSoup(html, "html.parser").find("article")
resultado = MarkItDown().convert_stream(
    io.BytesIO(str(principal).encode("utf-8")),
    stream_info=StreamInfo(extension=".html", charset="utf-8"),
)
print(resultado.text_content)
No todas las webs usan <article>. Si find devuelve None, busca el contenedor principal de esa web concreta.
Nuestra opinión
Para preparar documentos de oficina antes de pasárselos a una IA, MarkItDown es la opción más cómoda de las que hemos probado: una sola herramienta, local y rápida, que acierta donde más importa, en las tablas y las hojas de cálculo. Pero no la usaríamos a ciegas: que un PDF escaneado salga vacío sin ningún aviso es un fallo de diseño que puede colarte documentos en blanco, así que comprobar la salida no es opcional. Si solo conviertes algún Word o alguna web suelta, pandoc sigue siendo una alternativa digna y más ligera.
Preguntas frecuentes
¿MarkItDown es gratis?
Sí. Es código abierto con licencia MIT. Solo pagarías si activas funciones que usan servicios externos, como Azure o un modelo de IA para describir imágenes o leer escaneados.
¿Sube mis documentos a internet?
No, al convertir archivos locales. En nuestra prueba no hizo ninguna conexión de red. Solo se conecta si le pides convertir una URL o activas las funciones opcionales de Azure o de modelos de IA.
¿Puede leer PDF escaneados?
No, por sí solo. Devuelve un resultado vacío sin avisar. Para eso existe el complemento markitdown-ocr, que necesita un modelo de IA con visión y una clave de API.
¿Es mejor que pandoc?
Depende del formato. En Word, pandoc detectó mejor la tabla, pero borró el título. En la web empataron. MarkItDown gana en Excel y PowerPoint, que pandoc 3.1 no lee, y en las tablas de los PDF frente a pdftotext.
Ficha de la prueba. MarkItDown 0.1.8 (commit b8f79c5), pandoc 3.1.3 y pdftotext 24.02. Linux x86_64, 2 vCPU, 7,8 GB de RAM, sin GPU, Python 3.11. Prueba realizada el 28 de septiembre de 2026 por un agente de IA en un entorno aislado y revisada por la redacción. Límites: seis documentos sencillos creados por nosotros; documentos largos o con maquetación compleja (columnas, notas al pie, fórmulas matemáticas) pueden dar otros resultados. No hemos probado audio, YouTube, el complemento de OCR ni las funciones de Azure. Si detectas un error, escríbenos y lo corregiremos indicando la fecha.