Google quiere que un agente consulte datos históricos, transacciones y documentos sin moverlos todos al mismo almacén. El paquete Agentic Data Cloud anunciado el 4 de noviembre conecta el llamado borderless Lakehouse con AlloyDB, Spanner Omni y Knowledge Catalog. La consecuencia importante es que las piezas no comparten el mismo estado ni resuelven la misma tarea.
Cuatro piezas, cuatro funciones
| Componente | Función | Estado citado |
|---|---|---|
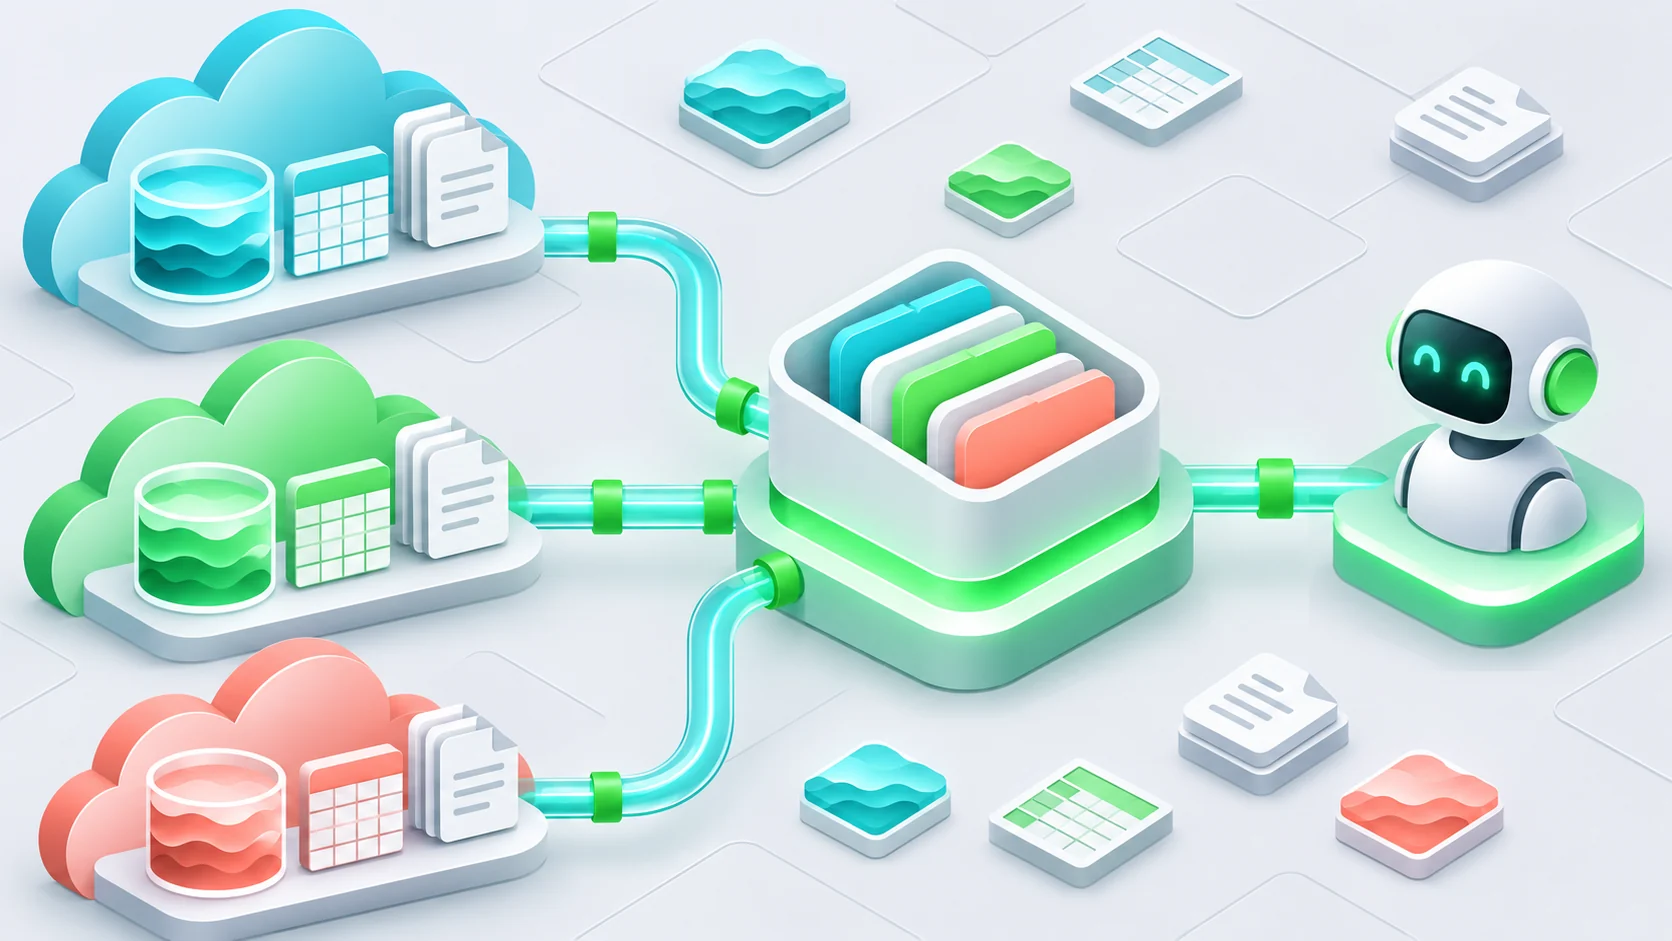
| Cross-cloud interconnect y caché | Consultar datos en AWS y Azure con conexión privada y caché en Google Cloud | Disponibilidad general |
| AlloyDB con acceso Iceberg | Unir datos operativos con tablas históricas sin una tubería ETL separada | Anunciado dentro del paquete; comprobar región y cuenta |
| Spanner Omni | Ejecutar Spanner en híbrido, edge y multicloud | Disponibilidad general |
| Knowledge Catalog enrichment | Curar contexto desde documentos, tickets y repositorios | Preview |
La arquitectura evita presentar «todos los datos» como una sola base. Lakehouse conserva tablas Iceberg, AlloyDB aporta la parte transaccional y Knowledge Catalog construye el contexto que ve el agente. Eso reduce copias en algunos recorridos, pero no elimina permisos, contratos de datos ni el coste de consultar fuentes remotas.
Las cifras siguen siendo del fabricante
Google atribuye a Knowledge Catalog casi cuatro veces más precisión, hasta un 33 % menos de latencia y hasta un 75 % menos de tokens en sus pruebas internas. También afirma que AlloyDB con acceso directo a Iceberg fue hasta siete veces más rápido en consultas de agregación que un servicio PostgreSQL compatible de Amazon. El anuncio no aporta en esos párrafos un conjunto de datos completo que permita extrapolar las cifras a cualquier carga.
Un caso citado de Delivery Hero/talabat atribuye una reducción aproximada del 40 % en costes de movimiento de datos al federar tablas Iceberg de S3 con BigQuery. Es un testimonio incluido por Google, no una auditoría independiente.
Qué debe decidir un equipo
Si la tarea es preguntar sobre datos que ya residen en varios proveedores, la conexión y la caché pueden evitar una migración inicial. Si el agente debe combinar una operación actual con historia analítica, AlloyDB e Iceberg cubren otra capa. Si el problema es que términos y documentos carecen de significado compartido, la pieza relevante es Knowledge Catalog, todavía en preview para el enriquecimiento automático.
Antes de adoptar el paquete, conviene fijar una consulta representativa, su región, permisos, volumen transferido, latencia aceptable y coste de caché. El anuncio no publica un precio único para Agentic Data Cloud ni convierte esas cuatro piezas en una suscripción homogénea.
Transparencia: noticia elaborada con asistencia de IA a partir del anuncio y la documentación enlazada por Google. Texploto no desplegó los servicios ni reprodujo los benchmarks.