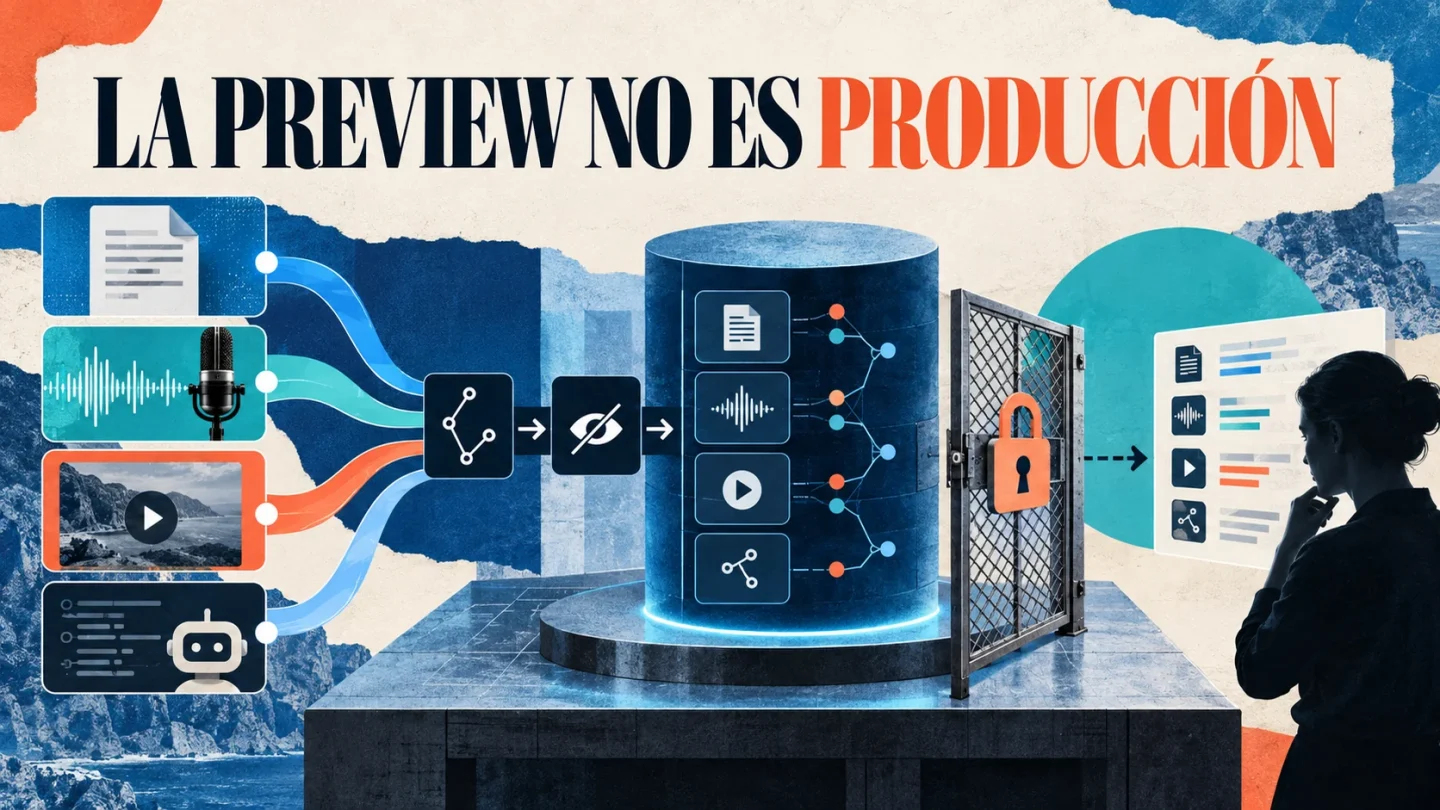
DigitalOcean ha abierto una preview privada de Agent Data Services, una capa administrada para convertir documentos, audio, vídeo y trazas de agentes en datos consultables. El producto reúne ingestión, transformación, catálogo, linaje y búsqueda; todavía no ofrece SLA, certificaciones estándar ni un precio estable para decidir una migración.
La presentación del 12 de octubre sitúa el servicio como base de un ciclo de mejora: el agente lee conocimiento, escribe sus trazas y otras herramientas evalúan el resultado. La documentación verificada ese mismo día permite separar la arquitectura disponible de la promesa comercial.
Procesar al entrar evita repetir inferencia al consultar
Los flujos pueden transcribir, dividir, incrustar, redactar campos, extraer atributos y ensamblar sesiones. El resultado se guarda una vez; una consulta posterior lee tablas y vectores ya preparados. Esto puede reducir latencia y coste frente a volver a ejecutar modelos con cada pregunta, a cambio de pagar el procesamiento inicial y mantener actualizado el catálogo.
La preview admite datos conductuales —eventos, clics, trazas y sesiones— y contenido multimodal. Acepta buckets de Spaces o compatibles con S3 y cargas por API. Los registros estructurados se almacenan en tablas Apache Iceberg y los embeddings en una base vectorial administrada, pero el cliente accede a ambos mediante la capa de consulta, no directamente.
«Al menos una vez» obliga a diseñar para duplicados
La documentación indica que los flujos entregan registros al menos una vez. Un reintento puede procesar el mismo registro más de una vez. Esa frase técnica cambia el diseño: cada evento necesita identificador estable y las transformaciones deben tolerar repeticiones, sobre todo si alimentan métricas o conjuntos de entrenamiento.
DigitalOcean permite hasta 40 réplicas por flujo y aplica control de acceso, redacción y reglas de moderación durante el proceso y la consulta. Cada espacio de trabajo vive en una sola región. La empresa afirma que los datos no entrenan sus modelos, aunque los modelos elegidos sí leen el contenido para producir las salidas del cliente.
Cuándo basta una base de conocimiento
La propia documentación reserva Knowledge Bases para búsqueda vectorial sobre documentos. Agent Data Services añade datos estructurados, trazas, multimedia, transformaciones, linaje y consultas analíticas. Si el caso solo necesita responder sobre una carpeta de documentos, la capa nueva puede ser complejidad innecesaria.
- Confirmar región, límites, precio y política de borrado antes de datos sensibles.
- Probar deduplicación y trazabilidad con reintentos.
- Separar datos para evaluación de datos usados en respuestas al usuario.
- No asumir equivalencia entre preview privada y servicio soportado.
La aportación concreta es convertir una lista de funciones en una decisión de arquitectura. El servicio tiene sentido cuando el problema incluye linaje, multimodalidad y trazas; no demuestra todavía fiabilidad de producción ni mejora autónoma de un agente.
Nivel de evidencia: documentación/fuente primaria. No se ha localizado una evaluación independiente sustancial ni hemos accedido a la preview.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. No se han ejecutado los productos o sistemas descritos.