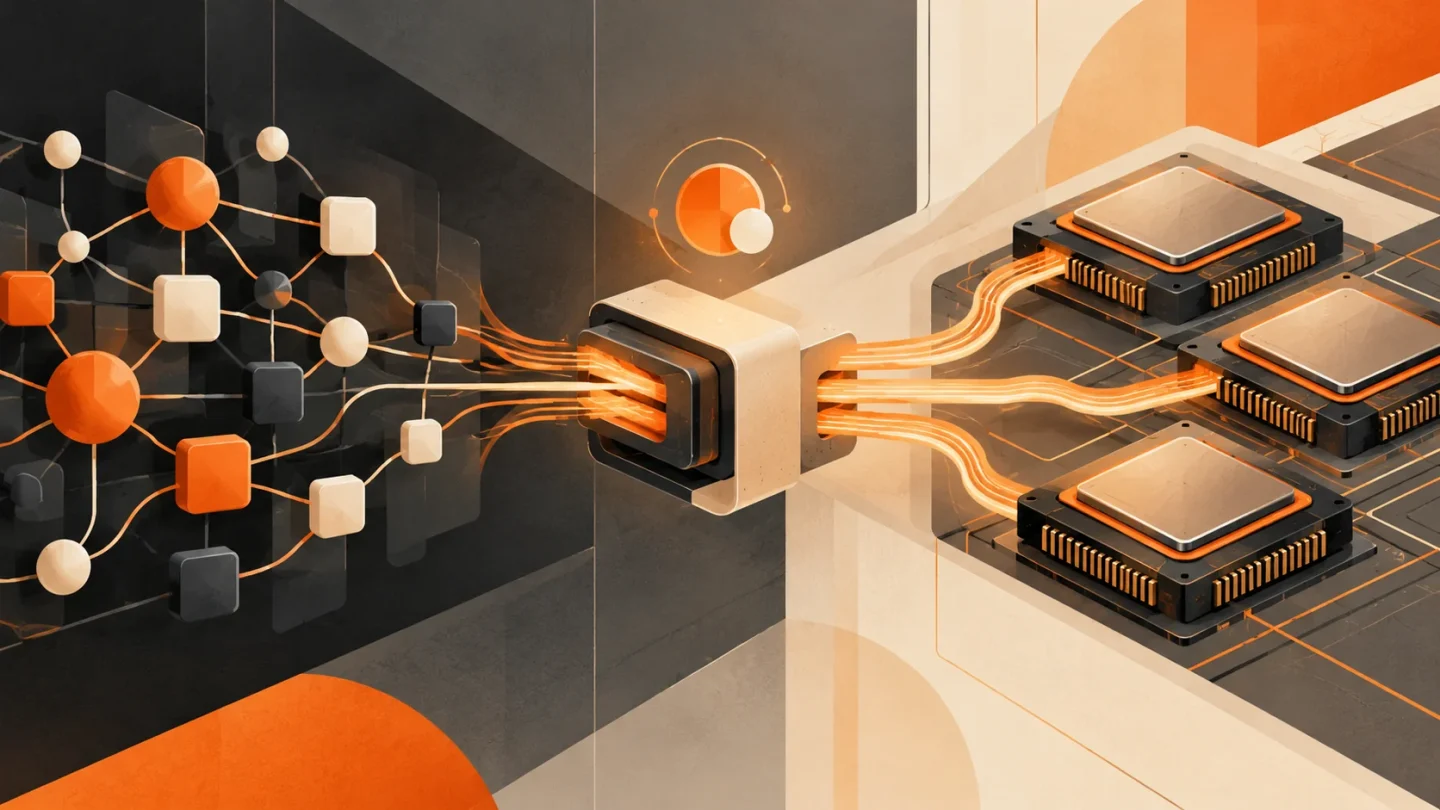
AWS y PyTorch abren hoy la beta pública de TorchNeuron, un backend que presenta Trainium como un dispositivo nativo de PyTorch. La promesa práctica es importante: mantener las APIs conocidas para entrenar, depurar y distribuir modelos, en vez de adaptar cada proyecto a una pila paralela. Pero «sin reescribir» no significa «sin volver a validar».
El anuncio de PyTorch sitúa el lanzamiento en código abierto bajo Apache 2.0 el 20 de octubre y limita el soporte a Trainium2 y Trainium3. La integración de Hugging Face añade compatibilidad nativa en Transformers, Diffusers, Accelerate, PEFT y TRL. Ambas fuentes documentan la integración y sus objetivos; no constituyen un benchmark independiente de rendimiento.
Qué cambia frente a Optimum Neuron
Hasta ahora, Optimum Neuron ocultaba una integración basada en PyTorch XLA: ejecución diferida, formas estáticas y recompilaciones ante cambios del grafo. TorchNeuron se registra mediante los puntos de extensión de PyTorch y permite usar torch.compile, ejecución eager, torch.profiler, FSDP y paralelismo tensorial con interfaces habituales.
| Área | Promesa de la beta | Comprobación necesaria |
|---|---|---|
| Modelo | Moverlo al dispositivo neuron |
Operadores y arquitectura soportados |
| Depuración | Ejecución eager y trazas conocidas | Coste de compilar operaciones y memoria |
| Entrenamiento | FSDP2 y TP nativos | Distribución, checkpoints y convergencia |
| Producción | torch.compile para rendimiento |
Formas, caché de grafos, latencia y coste total |
La cobertura anunciada no equivale a portabilidad total
Hugging Face afirma que el 89 % de las cien arquitecturas de generación de texto más usadas funciona de serie, frente al 46 % con Optimum Neuron 0.4.5. La cifra describe arquitecturas compatibles en su propia integración; no prueba que el 89 % de los proyectos reales conserve rendimiento, precisión o extensiones personalizadas.
La propia guía enumera límites: recomienda caché estática para generación, desactiva las formas dinámicas automáticas en un ejemplo de TRL y señala que la carga asíncrona de pesos todavía no está soportada. Los kernels propios, operaciones fuera del catálogo y secuencias con muchas formas siguen siendo puntos de migración.
Una prueba de decisión necesita cuatro resultados
- Paridad funcional: mismas salidas dentro de una tolerancia definida y mismos checkpoints recuperables.
- Tiempo completo: incluir compilación inicial, calentamiento y ejecuciones repetidas, no solo el tramo estable.
- Coste efectivo: instancia, utilización y horas de ingeniería necesarias para mantener el proyecto.
- Salida reversible: confirmar que los checkpoints estándar vuelven a cargarse en otro acelerador.
Hugging Face documenta que un entrenamiento de ejemplo terminó en ocho chips Trainium2 y guardó un checkpoint estándar. Es una demo del creador, no una comparación controlada con GPU. Texploto no ha instalado TorchNeuron ni ha ejecutado código en Trainium.
Nuestra valoración es que la novedad no es otra cifra de aceleración, sino reducir la distancia entre el código PyTorch y el hardware de AWS. Esa distancia menor facilita evaluar una alternativa; no decide por sí sola que migrarla sea más barata ni más rápida.
Nivel de evidencia: demo del creador. Hugging Face documenta un entrenamiento de ejemplo; las capacidades proceden de PyTorch y Hugging Face, sin reproducción independiente examinada. Revisión de clasificación del 21/10/2026.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. No se han ejecutado los productos descritos.