OpenAI ha sustituido el backend que sirve su monorepo por Pando, una arquitectura compatible con el protocolo y el cliente Git que permite aceptar pushes a ramas distintas en paralelo. La empresa afirma que la migración redujo casi un 80 % la latencia mediana de push y elevó la fiabilidad de las fusiones, que en algunos periodos había caído por debajo del 90 %. La consecuencia para otros equipos no es instalar Pando —todavía no se ofrece como producto—, sino revisar si su cuello de botella está en Git o en cómo el servidor coordina ramas, prepara paquetes y atiende a CI.
El sistema comenzó a servir producción en abril y, según OpenAI, mueve cerca de un petabyte de datos Git al día. Ha llegado a entregar más de 57 TB de paquetes en una hora, con más del 99 % de esos bytes desde caché local. Son mediciones del productor sobre su propia infraestructura; no hay una reproducción independiente ni una configuración pública equivalente.
El cambio clave: coordinar por rama, no por repositorio
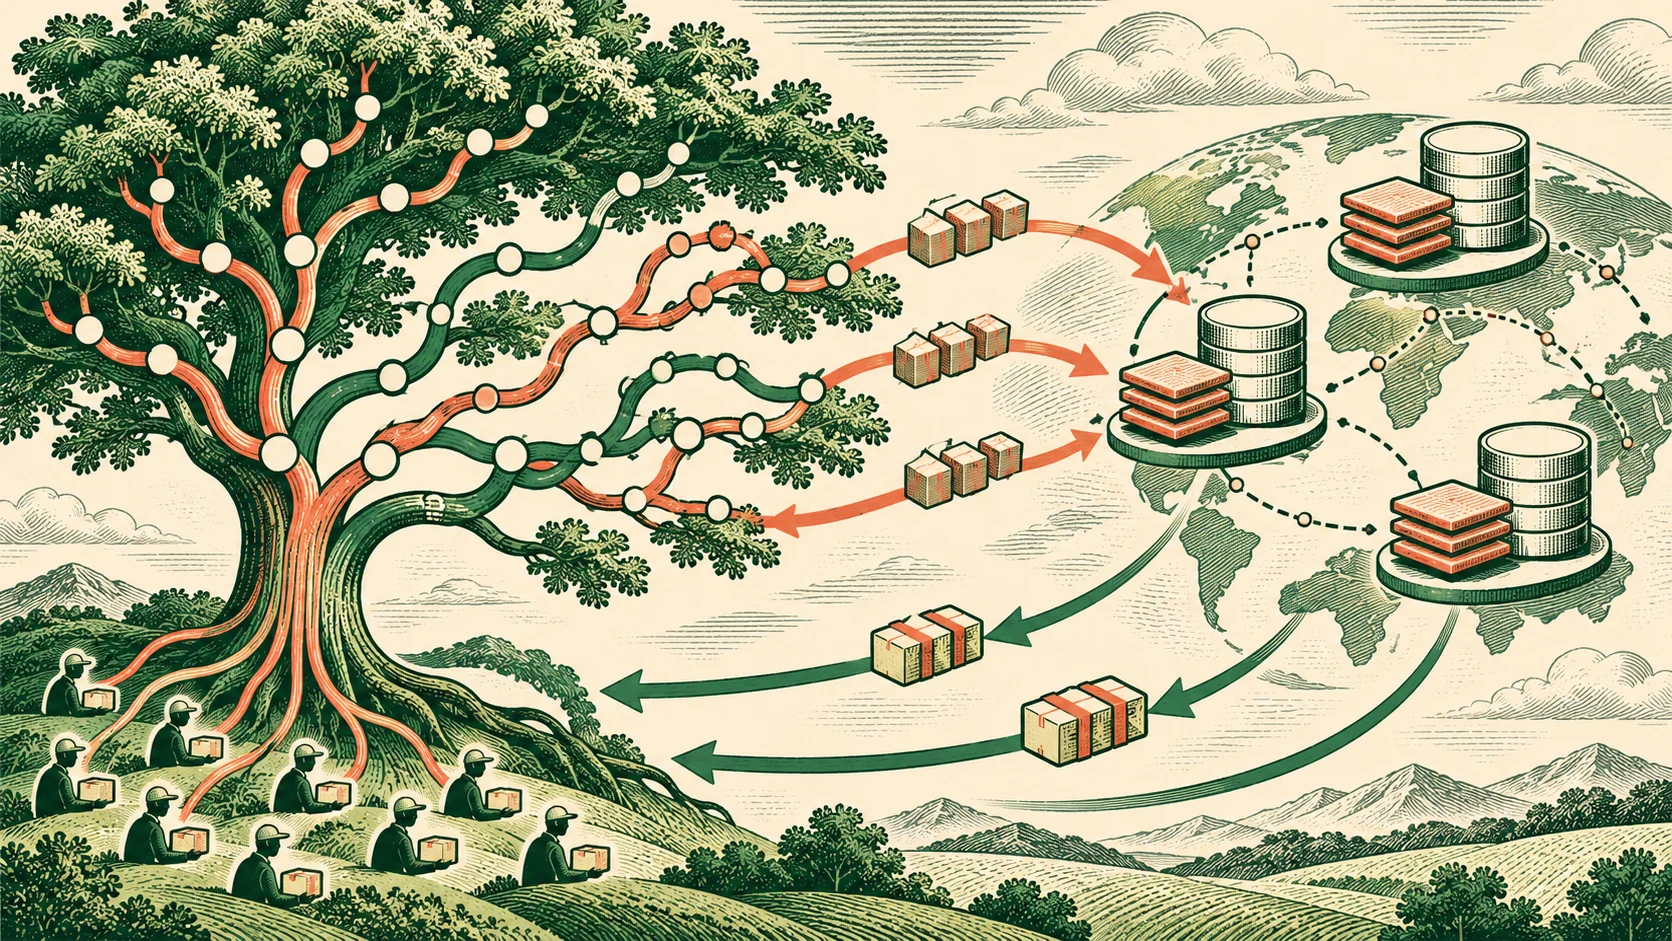
Un servicio Git necesita conservar objetos —blobs, árboles, commits y etiquetas— y referencias como refs/heads/main. Pando guarda el paquete recibido como un blob inmutable y registra una versión de la referencia con sus dependencias. Las escrituras solo compiten cuando intentan mover la misma referencia; dos agentes que trabajan en ramas diferentes no pasan por un único orden global.
El precio de esa paralelización es una coherencia más débil entre ramas. Una lectura conserva la historia necesaria para la referencia solicitada y cada rama es serializable, pero dos clientes pueden observar combinaciones distintas de versiones de foo y bar durante una operación. El artículo de OpenAI lo llama coherencia causal. No sirve para procesos que necesiten una instantánea simultánea de todas las referencias sin añadir coordinación.
| Enfoque comparado por OpenAI | Punto de coordinación | Consecuencia al crecer |
|---|---|---|
| Réplicas con 3PC | Quórum y bloqueo de referencias | La latencia de réplicas entra en el camino del push |
| WAL compartido | Un manifiesto común en almacenamiento de blobs | Pushes no relacionados compiten por actualizarlo |
| Pando | Puntero de cada referencia | Escala ramas independientes, sin instantánea global |
Reutilizar paquetes desplaza trabajo del servidor a la caché
En un servidor convencional, cada fetch puede exigir calcular y comprimir la diferencia entre los objetos que el cliente tiene y los que pide. Pando limita las referencias anunciadas al hacer push, conserva las dependencias del paquete y puede reutilizarlo para otros clientes. Un servicio regional llamado Express entrega esos paquetes desde cachés; el cliente usa la extensión packfile-uri para descargarlos.
Los paquetes pequeños se agrupan en segundo plano en coberturas de varios niveles. Esa compactación reduce el número de archivos necesarios para ponerse al día y mejora la compresión, pero OpenAI conserva los niveles anteriores porque un paquete pequeño puede ser más eficiente para leer un objeto concreto.
Qué puede medir un equipo antes de rediseñar su Git
- Contención: latencia de push separada por rama y cantidad de escritores simultáneos.
- Lectura: CPU del servidor al preparar packs, bytes transferidos y porcentaje servido desde caché.
- CI: cuántos trabajos descargan el mismo commit y cuánto repiten datos.
- Consistencia: qué automatizaciones dependen de ver todas las referencias en un mismo instante.
OpenAI dice que construyó Pando en diez semanas con Codex, una persona responsable del diseño central y equipos de agentes, además de pruebas de conformidad, simulaciones deterministas, TLA+ y Lean. Esa descripción documenta su método interno; no demuestra que otro equipo pueda repetir el calendario ni que agentes por sí solos garanticen corrección.
Parte del trabajo sobre descargas concurrentes, validación de paquetes y trazas se ha enviado al proyecto Git. Ese es hoy el resultado reutilizable. Pando sigue siendo infraestructura interna y OpenAI solo indica que explora cómo compartir su tecnología.
Transparencia: noticia elaborada con asistencia de IA a partir del artículo técnico de OpenAI. Texploto no tuvo acceso a Pando, no reprodujo las mediciones y no ejecutó el código.