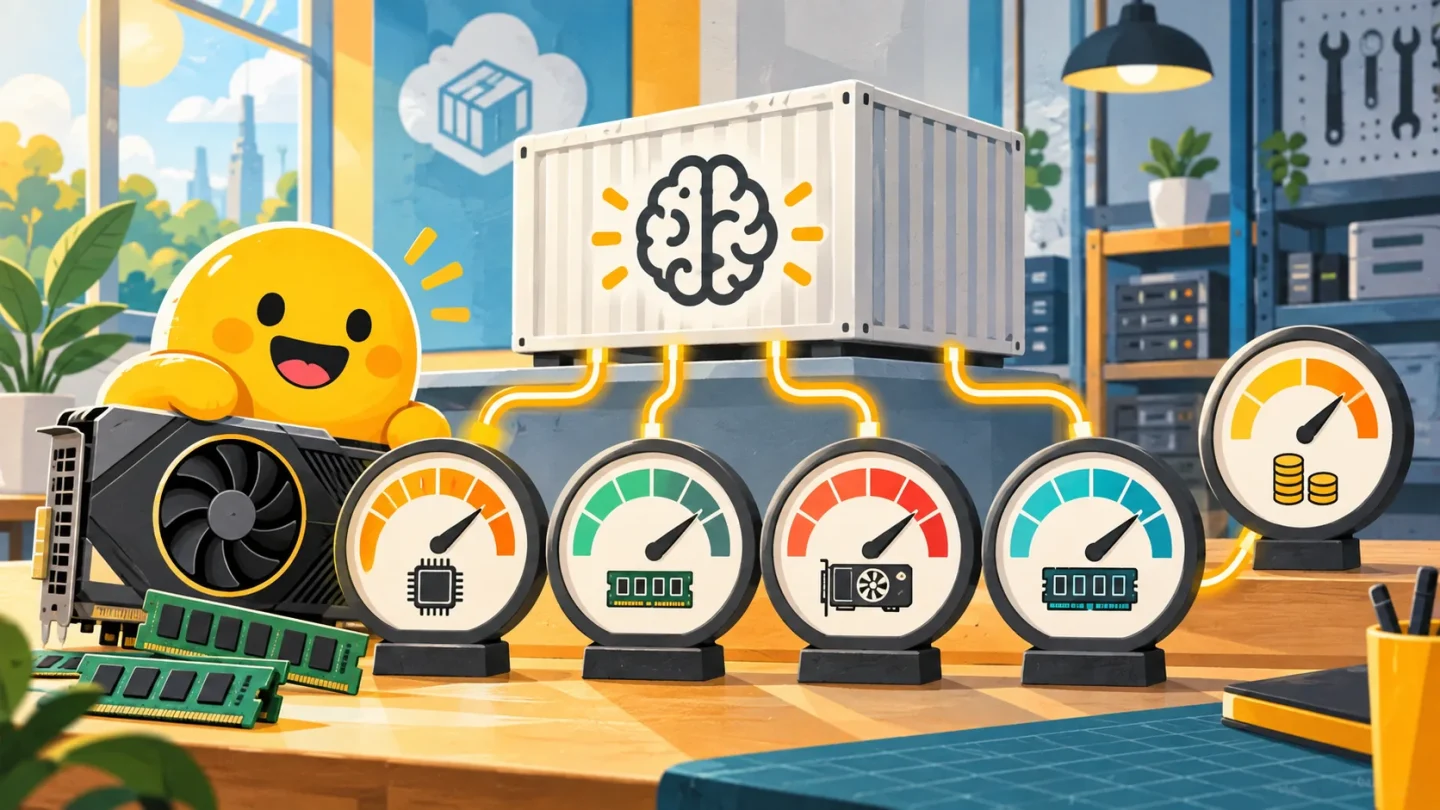
Hugging Face Jobs ya muestra el uso de CPU, RAM, GPU y VRAM mientras una tarea está en ejecución. El panel se actualiza cada pocos segundos junto a los registros. El cambio no abarata automáticamente un entrenamiento, pero hace visible una pregunta que antes exigía consultar estadísticas aparte: si el hardware contratado está trabajando o esperando.
El changelog del 25 de septiembre presenta el nuevo panel web. La documentación de gestión conserva el equivalente en consola con hf jobs stats, que añade tráfico de red y permite filtrar por uno o varios trabajos.
Cuatro señales y cuatro preguntas distintas
| Señal | Qué puede indicar | Qué no demuestra sola |
|---|---|---|
| CPU | Preprocesado, carga de datos o trabajo sin GPU | Que el cuello de botella esté en el procesador |
| RAM | Margen para lotes, caché o procesos auxiliares | Que bajar de instancia no vaya a provocar picos |
| GPU | Si el acelerador participa de forma sostenida | Que el modelo alcance su mejor rendimiento |
| VRAM | Cuánta memoria del acelerador ocupa la carga | Que otra GPU más barata admita el mismo pico |
Una lectura aislada puede engañar. Una GPU al 10 % durante la descarga de datos no implica que vaya a seguir ociosa durante el entrenamiento; una VRAM casi llena tampoco significa que los núcleos estén ocupados. Para decidir conviene observar varias fases, anotar los picos y compararlos con el tiempo total de ejecución.
Cómo traducir observabilidad a una decisión de coste
Jobs factura por minuto según el hardware mientras la tarea está en estado Starting o Running. La tabla oficial consultada el 28 de septiembre va, por ejemplo, de 0,40 dólares por hora para una T4 pequeña a 5 dólares por hora para una H200; los precios pueden cambiar y deben comprobarse antes de lanzar el trabajo.
Un ejemplo meramente aritmético: si una tarea de dos horas ocupa 20 GB de VRAM y mantiene baja la GPU en todas sus fases, el panel justifica investigar una instancia menor o un lote diferente. No demuestra que el cambio sea viable. Hay que repetir el mismo trabajo, conservar la versión, los datos y el criterio de éxito, y comparar coste total, duración y resultado.
Dos límites que evitan una factura accidental
El timeout predeterminado es de 30 minutos; para trabajos más largos hay que ampliarlo de forma explícita. También se puede fijar un límite de gasto mensual en organizaciones y grupos compatibles. Cancelar un trabajo irrelevante detiene su facturación, mientras que cerrar el portátil no detiene una tarea remota.
No hemos ejecutado Hugging Face Jobs ni medido un ahorro. La evidencia disponible procede del fabricante y documenta visibilidad y facturación, no una reducción universal del coste. El valor del panel aparece cuando se combina con una comparación controlada, no cuando se interpreta un medidor sin contexto.
Si todavía estás eligiendo dónde ejecutar un cuaderno, revisa también qué incluye Colab con un plan de Google AI y cómo comprobar su activación. El saldo de Colab y la facturación de Jobs pertenecen a servicios distintos. Compara el coste del trabajo completo y su duración, sin suponer que una suscripción de uno paga el uso del otro.