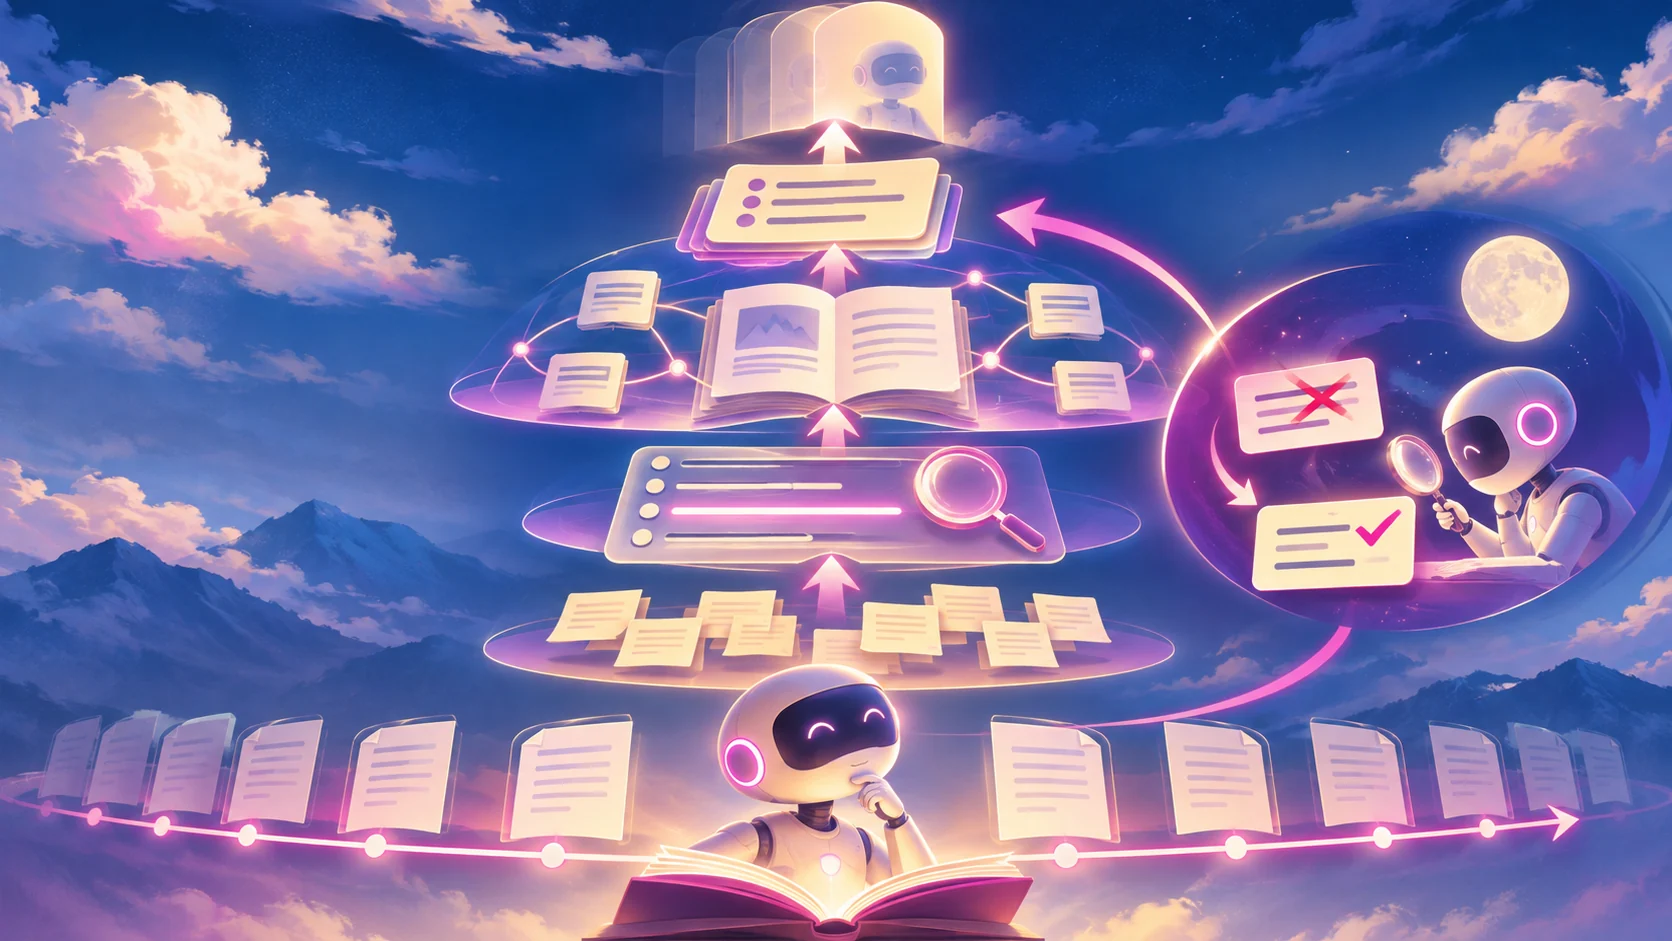
Anthropic propone separar la memoria de un agente en registros buscables, notas, representaciones como wikis y un índice pequeño que se inyecta en cada sesión. Un proceso en segundo plano, llamado dreaming, revisa transcripciones, corrige notas y reorganiza esas capas. Las evaluaciones muestran mejoras, pero también wikis más grandes que sus fuentes y errores capaces de propagarse.
La investigación define memoria como conocimiento obtenido en tareas anteriores y conservado entre sesiones. No incluye cambiar los pesos del modelo, aprender dentro de una sola conversación ni compactar turnos antiguos para continuar en la misma ventana.
Una carpeta persistente mejora CL-Bench, según Anthropic
En una tarea de base de datos de CL-Bench 1.0, Opus 5.5 pasó de 0,655 sin memoria a 0,838 con un directorio persistente; Sonnet 5.5, de 0,644 a 0,833. Son resultados del productor sobre esa tarea concreta, no una tasa esperable para cualquier agente.
Los modelos más capaces guardaron reglas verificadas, la evidencia de cada regla y advertencias sobre trampas. Los más antiguos acumularon teorías sin probar o no leyeron sus notas. Una instrucción rígida para registrar solo fallos redujo parte de la mejora en Opus 5 y Opus 4.7.
La memoria pequeña puede ser mejor
En una ejecución de Pokémon, un modelo antiguo archivaba casi cada encuentro. Fable 5 conservó una carpeta mucho menor y progresó más. Opus 5.5 mantuvo objetivos y próximos pasos, los reescribió durante la partida y terminó el juego.
El criterio no es recordar más, sino conservar lo que permitirá decidir después. Como ninguna sesión conoce el futuro, ese juicio puede fallar. Anthropic describe un caso en el que una nota situó un punto de referencia en el lado equivocado; el agente repitió el error hasta que el proceso en segundo plano comparó la nota con la transcripción y la corrigió.
Buscar y sintetizar resuelven tareas distintas
En preguntas que exigían combinar varios documentos, una wiki alcanzó un 87 % frente al 73 % de búsqueda directa. En otra evaluación, wiki más búsqueda subió del 54 % al 61 % y ahorró unos 20.000 tokens por pregunta frente a la búsqueda sola.
La representación no siempre ayuda. Cuando la respuesta estaba en un único documento, la wiki no aportó una mejora clara. En otro caso creció hasta 203 KB frente a 115 KB del corpus: 1,77 veces el material original. Una síntesis que no reduce ni organiza añade coste y otra superficie de error.
Lo inyectado en cada sesión debe ser pequeño
Claude Code carga solo las primeras 200 líneas o 25 KB de MEMORY.md y usa esa cabecera como índice. Anthropic advierte de que una nota incorrecta inyectada se propaga a todas las sesiones y que los archivos largos reducen la adherencia a instrucciones.
En otro ejercicio, varios agentes sobrescribieron una tabla compartida y conservaron 41 de 57 hechos contractuales. Al asignar una página por contrato y pedir citas literales, quedaron disponibles los 57. El resultado muestra un fallo de arquitectura y una corrección del productor; no demuestra que cualquier wiki generada sea fiable.
La decisión práctica es mantener el registro original como evidencia, usar notas para hechos validados y próximos pasos, construir representaciones solo cuando haya síntesis transversal y revisar periódicamente lo que se inyecta. La frecuencia y el coste de esa revisión siguen abiertos.
Context Mode aborda el ahorro dentro de una sesión; esta investigación trata persistencia entre sesiones, una intención distinta.
Transparencia: noticia elaborada con asistencia de IA a partir de la investigación y cookbooks de Anthropic. Texploto no ejecutó los benchmarks ni reprodujo la memoria.