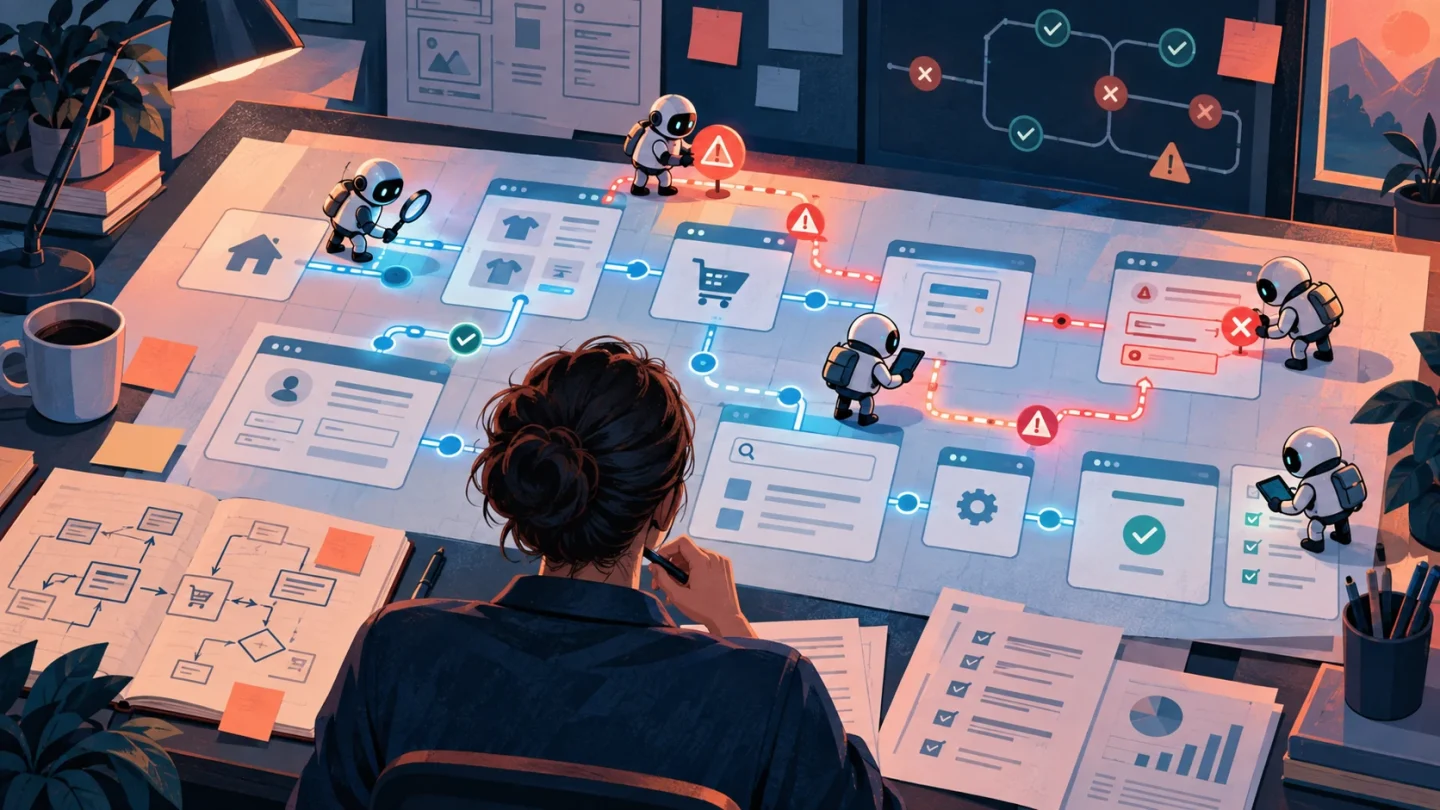
Momentic lanzó Mo, un agente que recibe una URL y una intención de prueba, explora la aplicación y devuelve fallos sin exigir que el equipo mantenga una segunda base de scripts. La propuesta ataca un coste real de las suites end-to-end: cada cambio de interfaz obliga a reparar selectores y flujos. También cambia el objeto que debe revisarse, porque una exploración generada no sustituye por sí sola una prueba repetible.
La página de Mo presenta una interfaz de conversación y una CLI. Según la entrevista publicada por SiliconANGLE, el agente puede recibir contexto desde un documento de requisitos, un ticket de Jira o Linear y una página de Confluence, y después coordinar varios agentes para recorrer la aplicación.
Mo elimina un artefacto, no la necesidad de especificar
| Enfoque | Qué conserva | Riesgo principal |
|---|---|---|
| Script end-to-end | Pasos y aserciones versionados | Mantenimiento frágil de selectores |
| Prueba en lenguaje natural | Intención legible, con cierta adaptación | Ambigüedad y deriva del intérprete |
| Agente exploratorio | Objetivo y contexto; decide el recorrido | Dos ejecuciones pueden cubrir cosas distintas |
La frase “sin scripts” no significa “sin preparación”. El agente necesita credenciales de prueba, datos seguros, un entorno estable, criterios de severidad y una definición de cuándo detenerse. Si el objetivo es “busca errores en el checkout”, puede encontrar un problema valioso; también puede saltarse una condición de negocio que nunca apareció en el contexto.
Cómo convertir un hallazgo del agente en una regresión
El resultado útil debería incluir al menos URL y versión, estado inicial, acciones observadas, datos empleados, evidencia del fallo y resultado esperado. Después, el equipo puede decidir qué hallazgos merecen una prueba determinista en CI. Esa separación conserva lo mejor de cada enfoque: exploración amplia para descubrir y aserciones estables para evitar que el fallo reaparezca.
Un flujo reproducible sería: ejecutar Mo contra una versión identificada; revisar y deduplicar los hallazgos; convertir los críticos en casos versionados; y volver a lanzar la misma prueba tras la corrección. Si el producto solo devuelve una narración sin estado inicial o pasos suficientes, el coste reaparece durante el diagnóstico.
Faltan comparaciones públicas para medir la promesa
Momentic sostiene que el agente reduce el mantenimiento de una colección paralela de tests. En las fuentes abiertas revisadas no aparece un benchmark independiente que compare tasa de defectos encontrados, falsos positivos, repetibilidad, coste y tiempo frente a Playwright, Cypress o una suite existente. Tampoco encontramos una tabla pública estable que permita calcular el coste por ejecución.
La cobertura de SiliconANGLE describe una demostración y recoge explicaciones del fundador; no es una prueba independiente del producto. Por eso no afirmamos que Mo detecte más errores ni que resulte más barato. Su novedad es el cambio de interfaz: de escribir cada paso a declarar intención y supervisar una exploración.
Las preguntas que deciden si encaja
- ¿Puede fijarse la versión del agente y conservarse el recorrido exacto?
- ¿Cómo se aíslan credenciales y datos de prueba?
- ¿Qué artefacto queda para reproducir un fallo en local o CI?
- ¿Cómo distingue un defecto de una variación visual aceptable?
- ¿Qué parte del resultado se puede exportar si se cambia de proveedor?
Texploto no ha ejecutado Mo. El nivel de evidencia es documentación del creador y cobertura periodística del lanzamiento, sin benchmark externo sustancial. La herramienta merece seguimiento por su enfoque; una adopción responsable debería medir repetibilidad y coste antes de retirar pruebas deterministas.
Transparencia: artículo elaborado con asistencia de IA a partir de las fuentes enlazadas. No se han ejecutado los productos o sistemas descritos.